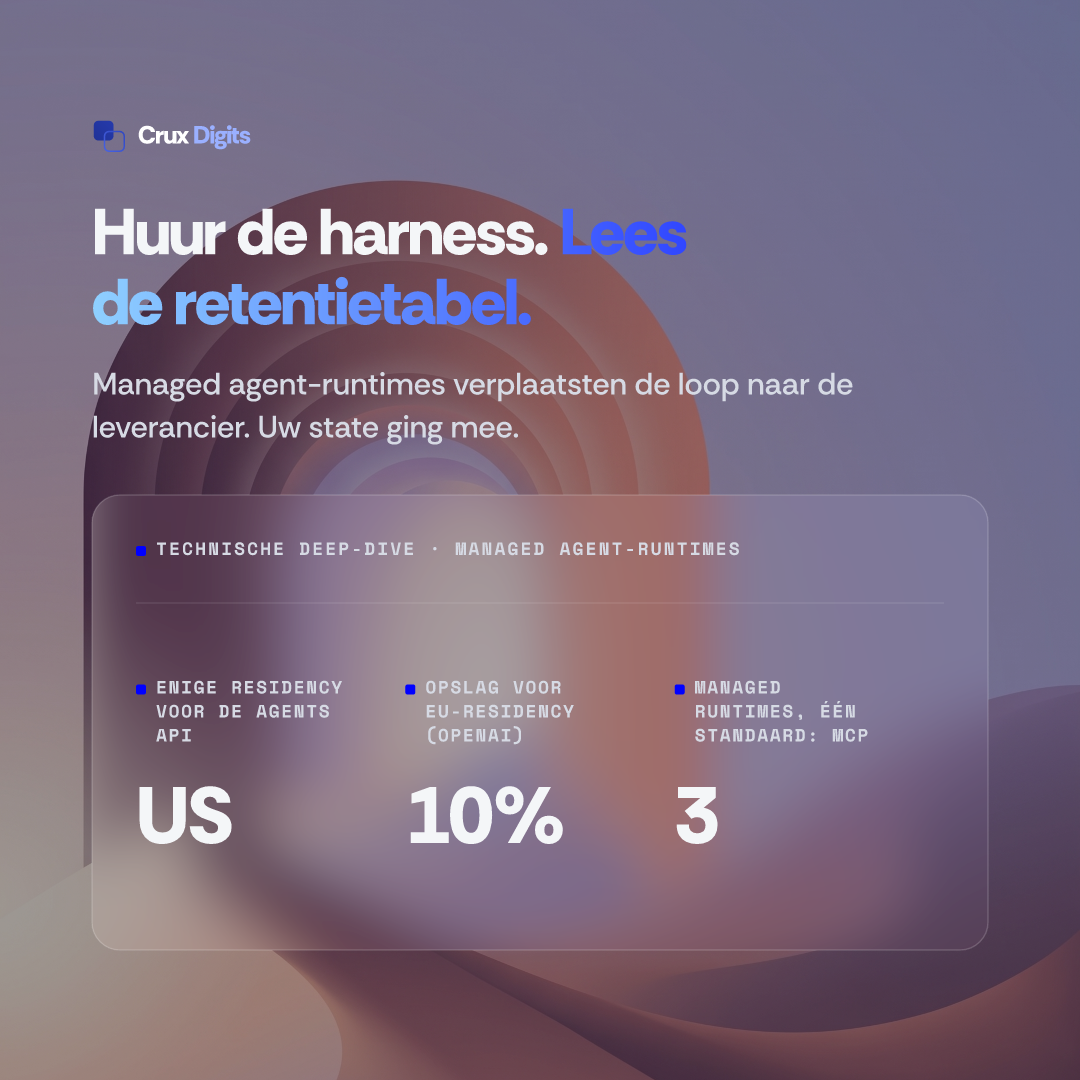
Een managed agent-runtime is een gehoste agent-loop. De leverancier draait de orkestratie, de contextcompactie en de coördinatie van subagents; u levert de tools en de opdracht. In 2026 verschenen er drie, en de vraag is niet langer of ze werken. De vraag is welk deel van uw agent nu op de control plane van een ander draait, en wat dat kost aan dataretentie, dataresidency en de prijs van vertrekken.
Wat is er in 2026 daadwerkelijk uitgekomen?
OpenAI bracht de Agents API op 10 september 2026 in publieke bèta. Die ontsluit dezelfde Codex-harness die de eigen coding agent van OpenAI aandrijft via één sessie-aanroep, waarbij contextcompactie, tool search, programmatic tool calling en parallelle subagents allemaal aan de serverkant worden afgehandeld. Anthropic was eerder: de Managed Agents-bèta draagt de header managed-agents-2026-04-01, en die dateert de interface betrouwbaarder dan de berichten van de lanceerdag, want die noemen afwisselend 8, 9 en 10 april. Google kwam uit de tegenovergestelde hoek. ADK 2.0 bouwde het framework zelf om tot een graph execution engine, waarin BaseAgent nu een subclass van BaseNode is, en deployt op Vertex AI Agent Engine.
Dit is een andere laag dan die uit AI-agentframeworks 2026. Een framework is een library die u zelf draait. Een managed runtime is een dienst die die library voor u draait. Wat er in 2026 gebeurde, is dat de loop zelf een product werd dat u huurt.
Het verhaal is sterk en grotendeels eerlijk. Lange sessies overleven contextlimieten omdat de leverancier eerdere beurten samenvat. Subagents waaieren uit zonder dat u een orkestrator schrijft. Tooldefinities laden pas wanneer ze nodig zijn, in plaats van tokens te verbranden aan een catalogus die het model toch niet gebruikt. En een harness die wordt onderhouden door de mensen die het model trainen, volgt het beter dan een die u er zelf naast bijhoudt.
Waar draait de loop, en waar draaien de tools?
Deze twee vragen hadden vroeger één antwoord. In 2026 liepen ze uiteen, en het door elkaar halen daarvan is precies waar compliance-reviews misgaan.
Anthropic biedt een environment-object waarvan het config-type cloud of self_hosted is. Cloud draait de container bij Anthropic. Self-hosted verplaatst de tooluitvoering naar u: u draait een worker met een environment key, die pollt de wachtrij van Anthropic, en de bash-commando's, het bestandssysteem en de netwerk-egress van de agent verlaten uw perimeter nooit. De agent-loop blijft bij Anthropic draaien. OpenAI biedt dezelfde vorm met meer opties: een door OpenAI gehoste sandbox, uw eigen compute, of een van negen partners waaronder Cloudflare, Modal, E2B, Oracle en Vercel.
Uw klantbestanden kunnen dus in een container in Amsterdam staan terwijl het transcript van wat de agent daarover dacht dat niet doet. Een self-hosted sandbox beantwoordt waar de code draait, niet waar de sessie wordt bewaard. Teams lezen het eerste antwoord en nemen aan dat het ook het tweede dekt, en dat is dit jaar de meest voorkomende fout in agent-architectuurreviews.
Waarom verliest het managed endpoint Zero Data Retention?
Dit is het deel dat vrijwel niemand heeft opgeschreven. OpenAI publiceert een retentietabel per endpoint in de documentatie over datacontroles, en naast elkaar maken die regels de ruil expliciet.
De endpoints voor chat completions en responses staan er allebei met een application state retention van None, geschikt voor Zero Data Retention, en geschikt voor Eyes Off en Safety Retention. Het agents-endpoint staat er met een application state retention van Until deleted, niet geschikt voor Zero Data Retention en niet geschikt voor Eyes Off. Conversations, threads en vector stores zitten in dezelfde niet-geschikte groep, en dat geeft het principe.
Het overzicht van de Agents API zegt hetzelfde in gewone zinnen: de Agents API ondersteunt dataresidency alleen in de Verenigde Staten en ondersteunt geen Zero Data Retention. Eén zin daar beantwoordt de vraag uit de vorige paragraaf. Een self-hosted sandbox kiezen maakt de Agents API niet ZDR-geschikt. Een container in uw eigen cloudaccount is een locatie; Zero Data Retention is een afspraak, en het eerste verplaatsen koopt het tweede niet.
Een team dat zijn eigen loop op het responses-endpoint bouwde onder Zero Data Retention, en die daarna naar de managed Agents API verhuist voor gratis compactie en subagents, valt daarmee dus buiten Zero Data Retention. Niets aan die migratie ziet eruit als een compliance-wijziging. Het ziet eruit als het verwijderen van orkestratiecode. Noemt uw DPIA of uw klantcontract Zero Data Retention, dan is dit een blokkerende wijziging, geen refactor. Niets daarvan is verborgen of schandalig: het is de rekening voor de functionaliteit, want een sessie die een herstart overleeft is een sessie die iemand heeft opgeslagen. De fout zit in het kiezen van de runtime zonder die regel te lezen.
Kunt u de data van een managed agent in de EU houden?
OpenAI documenteert zowel regionale opslag als regionale verwerking voor Europa, de EER plus Zwitserland, via een endpoint met prefix op eu.api.openai.com. Daar hangen twee voorwaarden aan: residency buiten de Verenigde Staten vereist goedkeuring voor aangepaste misbruikmonitoring en een amendement op de retentieafspraken, en residency-endpoints dragen een opslag van 10 procent voor in aanmerking komende modellen uitgebracht op of na 5 maart 2026. Regionale opslag betekent niet dat er ook regionale verwerking is, en de geschiktheid wordt endpoint voor endpoint opgesomd. Voor de Agents API is die opsomming al gedaan: het antwoord is de Verenigde Staten.
Anthropic zegt de beperking ronduit in plaats van u te laten afleiden. De instelling voor inferentiegeografie accepteert alleen de Verenigde Staten of global, en de workspace-geografie die de data in rust bepaalt is uitsluitend de Verenigde Staten, vastgelegd zodra de workspace is aangemaakt. De route naar EU-verwerking voor Claude loopt via AWS Bedrock of Google Vertex in een Europese regio, en daar draait de control plane van Managed Agents niet. U kunt Claude in Europa hebben, of Managed Agents. Vandaag zijn dat twee architecturen.
Google is voor een Nederlandse lezer de interessante. De locatielijst van het Vertex-agentplatform bevat europe-west4, en europe-west4 is Eemshaven, in Groningen. Daarmee is dit de enige van de drie waarvan de managed agent plane aan een datacenter op Nederlandse bodem kan worden vastgezet. Google hangt er een voorbehoud aan dat vermelding verdient: de documentatie waarschuwt dat een geregionaliseerde resource fysiek niet per se in de opgegeven regio staat, en verwijst wie een harde regulatoire eis heeft naar de residency-toezegging van de dienst zelf.
Bestaat er nog niets acceptabels, dan is dat een geldige conclusie die naar een andere architectuur wijst: private AI-assistenten, waar het model binnen uw eigen omgeving draait en residency niet langer een vraag aan een leverancier is.
Wat schrijft u werkelijk opnieuw als u overstapt?
Argumenten over portabiliteit worden meestal beweerd in plaats van uitgesplitst. Hier is de uitsplitsing.
Uw MCP-servers overleven. Alle drie de runtimes spreken het Model Context Protocol, en de specificatie van 28 juli 2026 maakte de protocolkern stateless, zodat een eenmaal geschreven toolserver blijft werken tegen een andere harness. Dit is het enige echt dragende stuk standaardisatie in de stack, en de reden om uw tools als MCP-servers te schrijven vóórdat u een runtime kiest. Prompts en skills overleven grotendeels ook, want het is tekst, al verhuist de steiger die elke harness eromheen bouwt niet mee: reken op bijstellen, niet kopiëren.
Uw sessiemodel overleeft niet. Anthropic hanteert een vorm in twee stappen: maak eenmalig een geversioneerd Agent-object, en maak daarna Sessions die aan een specifieke versie worden vastgepind, waarbij model, systeemprompt, tools en MCP-servers op de agent staan in plaats van op de sessie, al mag een sessie precies die velden voor de eigen run overschrijven. De sessie van OpenAI draagt de agentconfiguratie inline mee. Die van Google is een workflowgraaf van nodes. Uw besturingscode is tegen precies één daarvan geschreven en geen van de drie vertaalt.
Uw operationele oppervlak overleeft evenmin, en dat deel wordt onderschat. Een Anthropic-sessie die u nodig heeft faalt niet: een openstaande toolbevestiging laat hem idle staan met stopreden requires_action en de blokkerende event-ID's erbij. Uw client moet opnieuw verbinden, de eventhistorie ophalen en ontdubbelen op event-ID, want de optionele event-delta's zijn best effort en worden nooit bewaard terwijl de gebufferde events dat wel zijn. Die herverbindingslogica is echte code, leveranciersspecifiek, en niets ervan verhuist mee.
De eerlijke schatting voor een overstap luidt dus: uw tools gaan mee, uw integratie met de control plane niet. Begroot een migratie als het opnieuw schrijven van de loop die u met de runtime juist wilde vermijden. Dat pleit niet tegen zo'n runtime, maar voor de modelonafhankelijke houding die het getal klein houdt.
Hoe factureren ze, en waarom verandert dat het ontwerp?
OpenAI stelt onomwonden dat er geen extra kosten aan de Agents API zitten: u betaalt voor de tokens en tools die uw agents gebruiken. Anthropic rekent sessieruntime af bovenop de tokentarieven, en de prijspagina zet dat op 0,08 dollar per sessie-uur. Analyses van derden noemen een hoger bedrag, dus houd de leverancier aan. Het detail dat de architectuur werkelijk bepaalt is wat níét meetelt: runtime loopt alleen terwijl een sessie draait, dus tijd die idle wordt doorgebracht in afwachting van uw volgende bericht of van een toolbevestiging is gratis.
Dat draait de voor de hand liggende lezing om, en dat is het benoemen waard omdat die lezing tot verkeerde architectuur leidt. Facturatie op tijd straft de menselijke goedkeuringsstap niet, want dat wachten is idle en idle kost niets. Ze straft lange onbemande stukken waarin de agent echt werkt. Breek een sessie dus niet af om uw state te herbouwen rond een goedkeuring die uren duurt: hem open laten is waar de runtime voor is. Een grote context opnieuw inlezen komt op de tokenrekening, niet op de klok.
Wat zouden wij een Nederlands team dit kwartaal adviseren?
Dit raakt het hardst bij bedrijven die groot genoeg zijn voor een DPIA en te klein voor een platformteam, in de praktijk grofweg 50 tot 500 medewerkers. Dat is de groep waar een managed runtime het aantrekkelijkst oogt, omdat hij precies het infrastructuurwerk wegneemt dat u niet kunt bemensen, en waar de retentie- en residencyregels het hardst aankomen, omdat u een compliance-verplichting draagt en niemand wiens taak het is om endpointtabellen te lezen. De bredere volgorde zetten we uiteen op toegepaste AI voor de middelgrote onderneming.
Vijf stappen, in deze volgorde. Eén: schrijf uw tools als MCP-servers vóórdat u een runtime kiest, want dat is het portabele bezit. Twee: haal de retentie- en residencyregels op voor de endpoints die u gaat aanroepen, en leg ze in de architectuurreview in plaats van in een voetnoot. Drie: bepaal wat een self-hosted sandbox werkelijk oplost; gaat het om klantbestanden, dan helpt hij, gaat het om het transcript, niet. Vier: houd uw eigen evaluatie en tracing aan, want een managed harness geeft u zijn events maar vertelt niet of de agent gelijk had; dat gat is het onderwerp van observability voor AI-agents. Vijf: laat de harness niet vertroebelen wie verantwoordelijk is.
Over dat laatste punt is de positie onder de AI-verordening het waard om zorgvuldig te formuleren. De Digital Omnibus, Verordening (EU) 2026/1744, stelde de kernverplichtingen voor hoog-risicosystemen uit bijlage III uit tot 2 december 2027, dus de hoogrisicoklok loopt later dan de meeste planningen uit 2025 aannamen. Wat niet is uitgesteld, is de AI-geletterdheidsplicht uit artikel 4, die de Omnibus herschreef tot een plicht om maatregelen te nemen die geletterdheid ondersteunen in plaats van te waarborgen, en die aanbieders en gebruiksverantwoordelijken gelijkelijk bindt, evenmin als de transparantieplichten uit artikel 50 over het melden van AI-interactie en het markeren van gegenereerde inhoud. Het huren van andermans harness huurt hun verplichtingen niet mee.
Niets hiervan pleit tegen managed agent-runtimes. Voor de meeste teams die hun eerste serieuze agent bouwen zijn ze de juiste standaardkeuze, om dezelfde reden dat de meeste teams geen eigen database horen te draaien. Het argument is smaller: de loop verdween niet toen u ophield hem te schrijven. Hij verhuisde, en nam uw state mee. Lees de tabel voordat u tekent. Welke vorm bij een specifiek proces past, daar is ons werk aan AI-agentontwikkeling voor, en de pagina over wat een AI-project kost zet uiteen waar een eerste bouw op uitkomt.