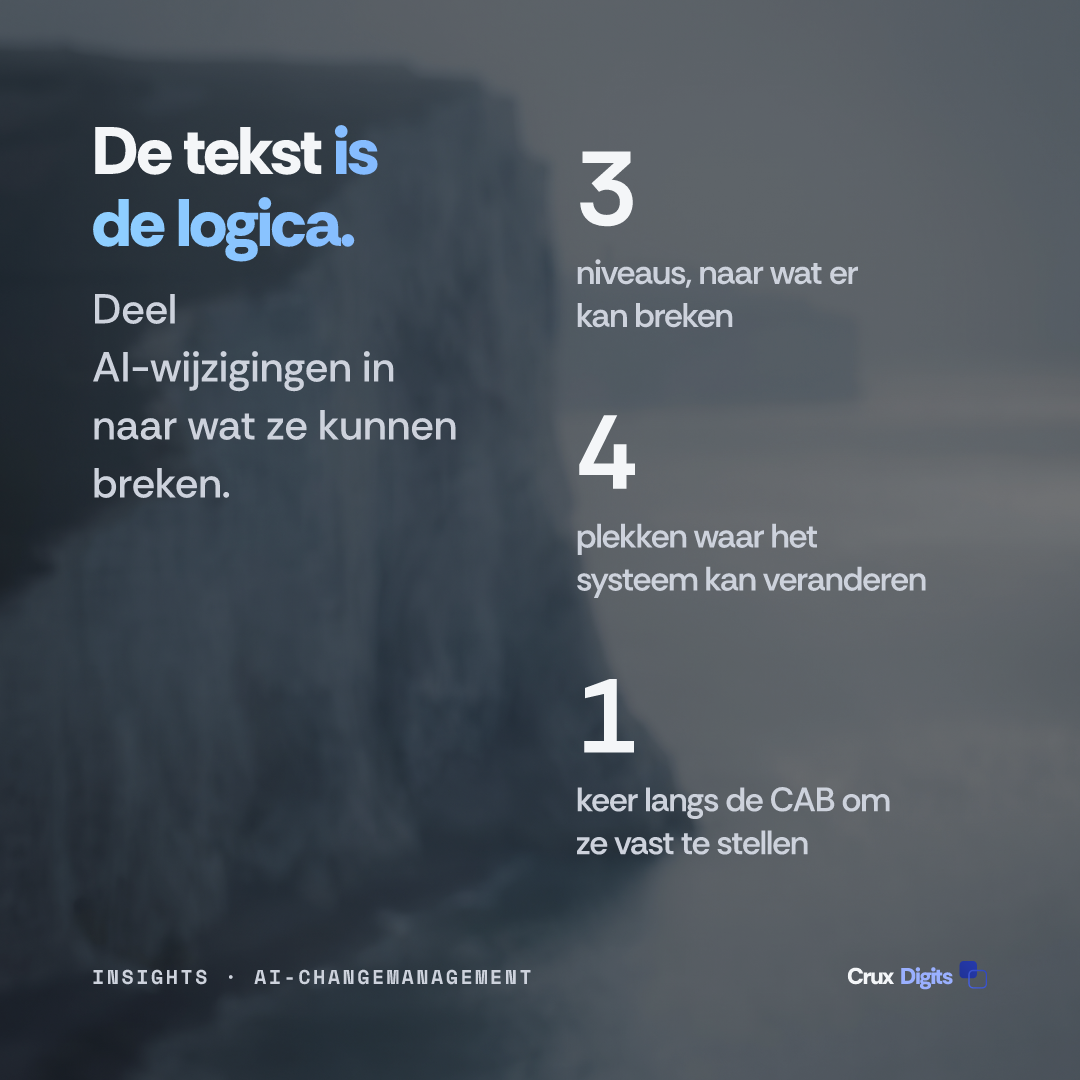
In IT-servicemanagement is AI-changemanagement bepalen welke wijzigingen aan een AI-systeem door uw wijzigingsproces moeten, en welke niet. Deel AI-wijzigingen in naar wat ze kunnen breken, niet naar welk bestand ze raken. Een nieuw document in de kennisbank hoeft niet langs de CAB. Een promptaanpassing van één regel die een weigering schrapt wel. En een gedragswijziging aan de kant van de leverancier keurt u helemaal niet goed. Die kunt u alleen signaleren.
Dit stuk is geschreven voor de IT-manager, changemanager of CIO van een organisatie met 250 tot 5.000 medewerkers, waar al elke week een change advisory board vergadert en waar een gespecialiseerde AI-leverancier binnenkort iets in productie gaat nemen. Met changemanagement bedoel ik hier change enablement in ITIL-zin: RFC's, wijzigingstypen, de CAB. Niet de organisatorische variant over mensen en adoptie; dat is een ander essay. Ik leid zelf zo'n gespecialiseerde leverancier. Wat volgt is de indeling die wij klanten voorstellen, en ik zeg erbij waar die ons iets kost.
Waarom verandert een AI-systeem zonder release?
Changemanagement volgens ITIL is gegroeid rond een artefact. Er wordt iets gebouwd, getest, verpakt en uitgerold; de RFC beschrijft dat artefact en de CAB weegt het risico van de uitrol. Het hele apparaat rust op één aanname: als er niets is uitgerold, is er niets veranderd.
Een AI-systeem doorbreekt die aanname op vier plekken.
- De prompt. Een systeemprompt is tekst, staat vaak als configuratie opgeslagen, en wie hem aanpast, verandert vanaf het volgende verzoek wat het systeem tegen elke gebruiker zegt. Geen build, geen uitrol, geen versienummer, tenzij iemand er bewust een heeft toegekend.
- De kennisbank. Voeg een document toe aan de verzameling waaruit een retrievalsysteem put, en de antwoorden veranderen zonder dat er één regel code is aangeraakt.
- Het model. Overstappen op een nieuwere modelversie lijkt het meest op een klassieke release, en juist die wijziging gaat het vaakst mis als ze als routine wordt behandeld.
- De serverlaag van de leverancier. Die verrast veel mensen. Anthropic schrijft in zijn eigen documentatie dat een model-ID een vastgezette snapshot is waarvan de gewichten niet veranderen, maar dat de infrastructuur eromheen, zoals de router, de veiligheidsclassifiers en de samplinglogica, wel kan veranderen, en dat zulke updates soms tot kleine verschillen in waarneembaar gedrag leiden. Dat is een modelleverancier die open kaart speelt, en het is precies de zin die u moet lezen voordat u een SLA opstelt. Het gedrag in productie kan verschuiven op een dag waarop aan geen van beide kanten van het contract iemand iets heeft uitgerold.
De organisaties die ik spreek, belanden daardoor meestal in een van twee situaties. Of er komt niets wat met AI te maken heeft bij de CAB, omdat er niets is "uitgerold", en het systeem drijft af zonder dat iemand ervoor tekent. Of alles gaat langs de CAB: de CAB besteedt veertig minuten aan de formulering van een prompt, de volgende formulering gaat op vrijdagmiddag zonder RFC live, en het proces delft stilletjes het onderspit. Beide falen. De tweede faalt langzamer, en daarom denken mensen dat die werkt.
Welke aanname van het Nederlandse beheermodel houdt geen stand bij AI?
Nederlandse IT-organisaties hebben de woorden voor dit probleem al. Ze passen ze alleen nog niet toe op AI. Vanaf 1986 beschreef Maarten Looijen, later hoogleraar aan de TU Delft, de driedeling van beheer waarop de meeste Nederlandse IT-afdelingen nog altijd zijn ingericht: functioneel beheer aan de kant van de business, applicatiebeheer voor de software, technisch beheer voor de infrastructuur. De driedeling kreeg een plek in ITIL, ASL en BiSL, en ze leeft voort in functietitels als functioneel beheerder.
De driedeling rust op een grens die al decennia standhoudt. Functioneel beheer verandert hoe een applicatie wordt gebruikt en ingericht; applicatiebeheer verandert wat ze doet. Een functioneel beheerder kan een productcode toevoegen, een workflowinstelling aanpassen of een briefsjabloon herschrijven zonder RFC, omdat geen van de drie de logica raakt.
Een prompt ligt precies op die grens, en doorbreekt die. Hij wordt bewerkt als een briefsjabloon, door iemand aan de businesskant, vaak in een tekstveld. Hij gedraagt zich als code. De zin "noem nooit een leverdatum" is een stuk logica, en wie hem schrapt, verandert wat het systeem een klant mag beloven. In een AI-systeem is de tekst de logica.
Voor Vlaamse lezers: Looijen is een Nederlandse referentie. Ook als uw organisatie zijn begrippen niet gebruikt, trekt elke IT-afdeling die met ITIL werkt de grens die hij beschrijft: tussen een applicatie inrichten en haar logica wijzigen.
Hoe deelt u AI-wijzigingen in? Drie niveaus naar wat ze kunnen breken
De regel die ik voorstel: het niveau van een wijziging wordt bepaald door het ergste wat ze kan breken, niet door de omvang van de aanpassing of het soort artefact. In de praktijk valt dat zo uit.
Niveau 1: wijzigingen in wat het systeem weet
Inhoudelijke wijzigingen: documenten in de kennisbank toevoegen of bijwerken, een FAQ-antwoord corrigeren, een productcatalogus verversen. Die veranderen welke feiten terugkomen, niet de regels waarmee het systeem ze behandelt. Ergste geval: een foutief of verouderd antwoord over één onderwerp, hetzelfde risico als een foute pagina op het intranet.
Route: geen RFC. Eigenaar is de inhoudseigenaar in de business, in de termen van Looijen functioneel beheer. De toets is een automatische run van de evaluatieset na elke indexupdate, met een drempel. De vastlegging is de indexversie in het log, zodat een incident terug te voeren is op wat het systeem die dag wist.
Niveau 2: een standaardwijziging voor hoe het systeem zich binnen zijn grenzen gedraagt
Promptaanpassingen in toon, vorm of opbouw; retrievalinstellingen, zoals het aantal passages dat wordt opgehaald; een overstap naar een nieuwere, vastgezette versie binnen dezelfde modelfamilie. Ergste geval: de antwoorden worden over de hele linie slechter, en dat is meetbaar.
Route: een standaardwijziging in ITIL-zin. De CAB keurt de categorie één keer goed: wat er mag veranderen, welke evaluatieset met welke score moet slagen, wie aftekent en hoe terugdraaien werkt (de vorige promptversie uit het register, het vorige model-ID). Daarna gaan afzonderlijke wijzigingen zonder vergadering live, en wordt elke wijziging vastgelegd met verwijzing naar die vooraf gegeven goedkeuring. Daarvoor zijn standaardwijzigingen bedacht: laag risico, goed begrepen, herhaalbaar. De constructie is veel ouder dan generatieve AI. Alleen heeft niemand de meeste CAB's die ik tegenkom ooit gevraagd haar voor een prompt te gebruiken.
Niveau 3: wijzigingen in wat het systeem mag doen
Een nieuwe tool of schrijfrechten (het systeem kan nu een order aanmaken, een e-mail versturen, een record wijzigen); een nieuwe gegevensbron met persoonsgegevens; een nieuwe gebruikersgroep, zeker een externe; een overstap naar een andere modelleverancier; en elke promptaanpassing die een grens verlegt of weghaalt: wat het systeem weigert, wat het mag beloven, wanneer het het gesprek overdraagt aan een mens. Ergste geval: het systeem doet iets waarvoor het nooit is goedgekeurd, voor iemand die het nooit mocht bedienen.
Route: een normale wijziging via de CAB, met de privacy officer erbij zodra er persoonsgegevens in het spel zijn. En voor de minderheid van systemen die onder het hoogrisicoregime van de EU AI Act vallen, een vraag die een CAB niet gewend is te stellen: worden wij door deze wijziging de aanbieder? Artikel 25 bepaalt dat een gebruiksverantwoordelijke die een substantiële wijziging aanbrengt in een AI-systeem met een hoog risico, of het beoogde doel van een systeem zo verandert dat het een hoog risico krijgt, de verplichtingen van de aanbieder overneemt. De AI Act is inmiddels gewijzigd door de omnibus van 2026, die de datum voor zelfstandige hoogrisicosystemen uit bijlage III naar 2 december 2027 verschoof. Lees dus de geconsolideerde tekst voordat u op de details bouwt. Het principe, dat een wijziging die groot genoeg is ook verandert wie verantwoordelijk is, kunt u nu al meenemen naar de CAB.
De promptaanpassing van één regel is het voorbeeld dat CAB's overtuigt. "Noem nooit een leverdatum" schrappen is één regel, en niveau 3. Overstappen op de volgende vastgezette versie van hetzelfde model is technisch een grotere gebeurtenis en, met een evaluatieset die slaagt, niveau 2. Staat dat in uw indeling andersom, dan deelt u bestanden in. Dit betekent overigens niet dat de business voor elke formulering een ticket moet aanmaken. Daar is niveau 2 juist voor: formuleringen binnen een vooraf goedgekeurde categorie. Alleen de zinnen die een grens bepalen, vallen erbuiten.
En de wijzigingen die niemand indient?
De vierde soort wijziging heeft geen RFC, omdat er geen aanvrager is. U kunt haar niet goedkeuren, alleen signaleren. Daarmee hoort ze bij monitoring en incidentbeheer, niet bij change enablement: een geplande run van de evaluatieset tegen productie, dagelijks of wekelijks afhankelijk van het volume, met een drempel die een ticket opent. Daalt de score terwijl niets in uw wijzigingslog het verklaart, dan hebt u een wijziging aan de kant van de leverancier gevonden, en hebt u het bewijs om mee naar die leverancier te gaan. Wie dat ticket vervolgens oppakt, is de vraag uit ons eerdere essay over wie er gebeld wordt als een AI-systeem faalt.
Daarom duikt de evaluatieset steeds weer op in deze reeks. Niveau 1 wordt erdoor bewaakt, niveau 2 wordt er vooraf aan getoetst, en de vierde soort wijziging is alleen via de evaluatieset zichtbaar. Een IT-functie die haar eigen evaluatieset niet in handen heeft, kan hier niets van uitvoeren. Dat was de kern van ons stuk over het AI-vermogen dat u niet moet uitbesteden.
Heeft een kleiner bedrijf dit eigenlijk nodig?
Nee, en dat heb ik ook op papier gezet. In een stuk over AI-strategie voor kleine bedrijven schreef ik dat een bedrijf van dertig mensen geen AI-governanceboard moet oprichten, maar één regel op één proces moet leggen: wie een uitkomst goedkeurt voordat die bij een klant komt, met een log dat iemand aan het eind van de maand ook echt leest. Dat blijft staan. Dit essay gaat over een andere organisatie: een organisatie waar de CAB al bestaat, wekelijks vergadert en een voorzitter heeft. De vraag is daar niet of er governance bij moet, maar welke AI-wijzigingen u buiten een CAB houdt die er al is. De grens ligt ongeveer waar al een apart wijzigingsproces bestaat. Daaronder doen een log en een evaluatieset het werk.
Wat verandert ITIL 5 hieraan?
PeopleCert lanceerde in februari 2026 ITIL (Version 5) en positioneert het als AI-native. Er is een uitbreidingsmodule ITIL AI Governance verschenen, en herziene practice-handleidingen staan gepland voor de tweede helft van 2026. Het meeste wat er tot nu toe over wijzigingen in de nieuwe versie is geschreven, gaat over AI die helpt change enablement uit te voeren, bijvoorbeeld door het risico van een wijziging te schatten op basis van historische gegevens. Dat is nuttig, maar het is een ander probleem. AI gebruiken om uw wijzigingen in te delen, vertelt u niet hoe u wijzigingen aan AI indeelt, en of de herziene handleidingen daar uitsluitsel over geven, kan ik u nog niet zeggen.
Tot die tijd passen de drie niveaus zonder nieuwe uitvindingen in de bestaande wijzigingstypen van ITIL. Niveau 1 is een gegevenswijziging die buiten change enablement blijft, niveau 2 een standaardwijziging, niveau 3 een normale wijziging. Uw CAB heeft geen nieuw proces nodig, wel één vergadering om de categorieën vast te stellen.
Wat kost dit de leverancier, en waarom stel ik het toch voor?
Eerlijk is eerlijk: een indeling als deze maakt het werk van mijn bedrijf zichtbaarder, niet minder zichtbaar. Elke wijziging op niveau 2 die wij doorvoeren, wordt vastgelegd met verwijzing naar een vooraf gegeven goedkeuring die de klant zelf opstelde, elke wijziging op niveau 3 wacht op de CAB, en de evaluatierun laat de klant zien wanneer een van onze wijzigingen iets slechter maakte. Een leverancier die promptaanpassingen liever stilletjes doorvoert, zal dit niet voorstellen.
Ik stel het voor omdat het alternatief voor beide partijen slechter is. Een leverancier van wie de wijzigingen niet zijn ingedeeld, krijgt de schuld van elke afwijking, ook van afwijkingen die hij niet veroorzaakte, en heeft geen log om het tegendeel te bewijzen. In de praktijk is dit ook het grootste deel van de afstand tussen een AI-demo en AI in productie. Een demo hoeft nooit te weten welke promptversie een antwoord gaf. Een productiesysteem wel.
Waar begint u deze maand?
- Maak een lijst van alle AI-systemen in productie en noteer per systeem de vier plekken waar het kan veranderen: prompt, kennisbank, model, leverancier.
- Vraag uw AI-leverancier waar de promptversies staan, en of elk antwoord in productie te herleiden is tot een promptversie, een indexversie en een model-ID. Kan dat niet, dan is dat het eerste wat hij moet opleveren.
- Neem één voorstel mee naar de CAB: de drie categorieën, de evaluatiedrempel voor niveau 2 en de regel voor terugdraaien. Eén agendapunt, geen programma.
- Plan de evaluatierun tegen productie in, zodat de vierde soort wijziging ergens zichtbaar wordt.
Haalt u een specialist binnen naast uw ICT-partner, dan hoort deze indeling bij een AI-implementatie met ons. Hoe dan ook: de indeling is van u.
Wij bouwen maatwerk-AI en LLM-systemen die in productie draaien: een klikbare MVP bij het tweede gesprek, vaste stappen, en de code is van u.
AI-ontwikkelbureau in Nederland →