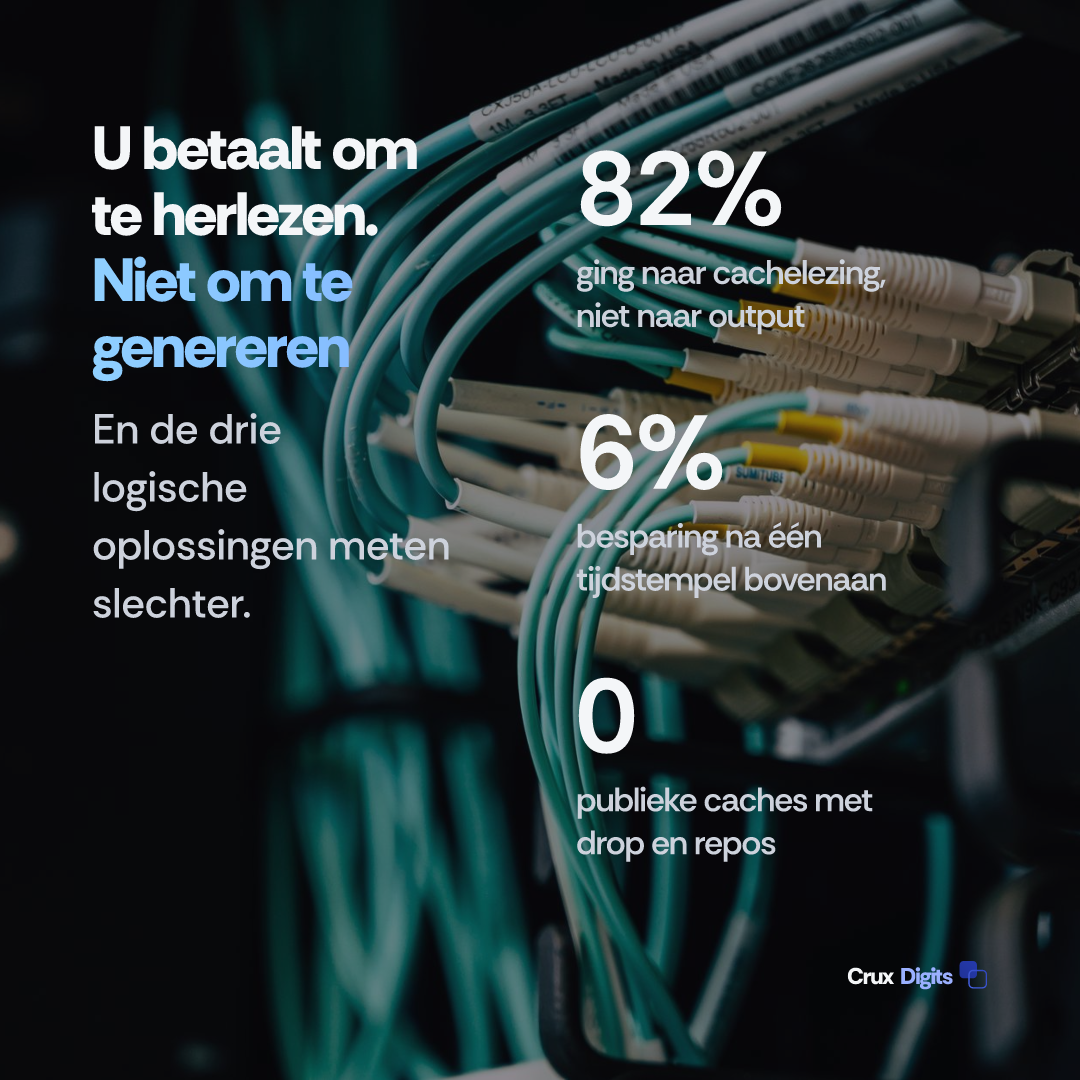
Een deze week verschenen onderzoek zet KV-cachelezingen op 82,4% van de totale API-kosten van een agent, niet de outputtokens. Samen hebben twee onderzoeken inmiddels de drie oplossingen gemeten waar een engineeringteam het eerst naar grijpt. De historie inkorten tot de laatste twaalf toolrondes kostte 1,85 keer de volledige-contextbasislijn. Samenvatten leverde ongeveer 7% op en kostte ruwweg vijf accuratessepunten. Comprimeren kostte 40,1% meer dan niets doen.
De lezer hier is wie de exploitatiekosten aftekent: de IT-manager, informatiemanager, IT-director of security officer in een Nederlandse of Vlaamse organisatie van 250 tot 5.000 medewerkers, met een ICT-partner die er al zit. Crux Digits specificeert en instrumenteert AI naast wie uw omgeving beheert; wij verkopen geen beheer, geen infrastructuur, geen hosting en geen servicedesk. De vraag is smal: als de rekening van een agent verschilt tussen twee runs van dezelfde taak, waar kijkt u dan eerst?
Waar gaat het geld in een agentrun werkelijk heen?
Cache Engineering for Agents, op 20 oktober 2026 op arXiv geplaatst door een groep onder leiding van de Tsinghua-universiteit, rapporteert dat KV-cachelezingen 82,4% van de totale API-kosten vormen in de onderzochte agentworkloads. Lees het met zijn grondslag erbij: het is berekend uit tokenaantallen tegen tarieven van open-weight modellen, niet afgelezen van een factuur van Anthropic of OpenAI, dus de verhouding verschuift op een endpoint waar cachelezingen een tiende van de basisinput of minder kosten. De richting overleeft dat, en die keert de intuïtie om waarop de meeste kostengesprekken rusten. De output van een agent per stap is een paar honderd tokens; de input is het hele traject tot dan toe, bij elke volgende stap opnieuw gelezen. Wat u ronde na ronde koopt is geen generatie. Het is herlezen.
De eigen oplossing van het onderzoek scheelt ongeveer een kwart. Gemiddeld over drie modellen en vier benchmarks verlaagde het AKV-systeem de kosten met 27,7% tegenover Standard, en dat is geen volledige-contextbasislijn maar juist de drempelsamenvatter van hieronder, waarbij het gemiddelde per model licht steeg in plaats van te dalen. Een kwart eraf van een post die vier vijfde van de rekening uitmaakt, is een grotere hefboom dan de meeste modelwissels.
Waarom wordt de rekening hoger als u de context inkort?
Omdat de cache een prefix is, en een prefix alleen herbruikbaar is tot aan de eerste wijziging. Verandert u eerdere trajecttekst, dan is elke gecachte toestand daarna ongeldig en prefilt het model de staart opnieuw. Hoe eerder de wijziging, hoe meer er herberekend moet worden. De historie inkorten is technisch gezien een wijziging vooraan.
Het meetresultaat is ongemakkelijk. Alleen de laatste twaalf toolrondes bewaren kostte 1,85 keer de volledige-contextbasislijn op GPT-OSS-120B over 100 taken. Samenvatten bij 48K tokens verlaagde de kosten met ongeveer 7% en de accuratesse met vijf punten: een slechte ruil in twee richtingen tegelijk.
Compressie was al gemeten en had al verloren. Een PayPal-onderzoek uit juli 2026, Cache-Aware Prompt Compression, vond query-afhankelijke compressie de duurste van alle geteste varianten, 40,1% boven een ongecachte, ongecomprimeerde basislijn op de tau-bench retailbenchmark, en precies om deze reden: een query-afhankelijke compressor maakt voor elke vraag een andere prefix en verslaat dus de cache die hij juist moest ontlasten. De query-onafhankelijke methode van datzelfde onderzoek, die het cachebreekpunt intact laat, was in alle 16 geteste configuraties op LongBench-v2 de goedkoopste. Compressie is niet de schuldige. Query-afhankelijke compressie is dat wel.
Daar zit de valkuil in één regel: het instinct om in te korten heeft gelijk over tokens en ongelijk over geld.
Welke cachebrekende wijziging maakt uw team per ongeluk?
Anthropic documenteert de regel helder in de referentie over prompt caching: de hiërarchie loopt via tools, dan system, dan messages, en een wijziging op één niveau maakt dat niveau en elk volgend niveau ongeldig. De vergelijking is exact, tot en met het blok dat de cachemarkering draagt. Er bestaat geen gedeeltelijke score.
Wat dit een verandermanagementprobleem maakt in plaats van een programmeerprobleem, is hoe gewoon de brekende wijzigingen eruitzien. Een gemodelleerde agentlus van 30 rondes, geprijsd in oktober 2026, bespaart bij correcte caching ongeveer 80% op Claude; zet een tijdstempel bovenaan de systeemprompt en dat zakt naar 6%. Zet een variabele waarde in een toolbeschrijving en dezelfde analyse mat 24% méér dan helemaal niet cachen, omdat tooldefinities bovenaan de hiërarchie staan. De documentatie van Anthropic noemt een subtieler geval: Go en Swift zetten sleutels in willekeurige volgorde bij JSON-conversie, waardoor een tool_use-blok de cache kan breken zonder dat er een diff te reviewen valt.
Eén plaatsingsregel hoort in een checklist: een breekpunt op een blok dat per verzoek verandert, schrijft elke keer een nieuwe entry en raakt nooit. Prefixstabiliteit is een eigenschap van uw wijzigingsproces, niet van uw promptstijl.
Ligt de oorzaak bij stille sessies of bij krappe toollussen?
Hier spreken de bronnen elkaar tegen, en die tegenspraak is het nuttigste eraan. Het leveranciersverhaal gaat over stilstand: een sessie pauzeert, het venster van vijf minuten verloopt, u betaalt opnieuw voor prefill. Anthropic verkoopt de remedie rechtstreeks: een TTL van een uur tegen tweemaal de basisinput bij write, tegenover 1,25 maal bij vijf minuten.
Een simulatie over echte traces vertelt iets anders. Toen 68.266 verzoeken uit 393 Claude Code-sessies door een blokgranulaire prefixcache-simulator werden gehaald, bleek het mediane interval tussen verzoeken 2,1 seconden en overschreed slechts 3,3% van de intervallen 300 seconden. Verzoeken na een interval onder tien seconden waren verantwoordelijk voor 33,1% van alle herberekende tokens; verzoeken na meer dan vijf minuten voor 17,5%. Een TTL-beleid van 300 seconden leverde in elke run exact dezelfde, byte-identieke resultaten als gewone LRU, wat wil zeggen dat de klok van vijf minuten nooit afging. De missers kwamen van capaciteitsdruk binnen krappe toollussen, niet van wachten.
Die auteur is zorgvuldig over de beperking en dat moeten wij ook zijn: die runs zijn capaciteitsgebonden en niet TTL-gebonden, waarmee ze een model zijn van zelfgehoste of dedicated serving, niet van een leveranciers-API. Dat voorbehoud is precies het punt. Hetzelfde symptoom, kosten per run die schommelen tussen identieke taken, heeft een andere oorzaak afhankelijk van waar de agent draait, en de remedie voor de ene oorzaak is dood gewicht tegen de andere. Siddhant Khare trok die scheidslijn als eerste, in een veldgids over agentic inference van 18 oktober die capaciteitsmissers en retentiemissers op dezelfde traces uit elkaar haalt en waarschuwt dat winst op de ene weinig zegt over de andere. Wat zijn twee takken niet dekken is de derde oorzaak, die in uw eigen prompt zit en niet in iemands servinglaag. Eén kanttekening bij het tracewerk zelf: de drie hazard-strategieën die daar van LRU verloren waren eigen varianten van de auteur en geen gepubliceerde systemen, dus lees het als bewijs dat LRU wordt onderschat, niet dat er iets is weerlegd.
Eén waarschuwing over instrumentatie, als indruk uit de praktijk en niet als onderzoek. In een vraaggesprek bij een leverancier van afgelopen juni noemde Doug O'Laughlin van SemiAnalysis waargenomen fysieke hitratio's "rond de 70 procent", bij een nieuwe sessie veel lager, terwijl hetzelfde stuk logische ratio's van 90% of meer noemt als wat multi-agentworkflows halen. Twee uitspraken over twee verschillende dingen, en juist daarom meet u beter uw eigen cijfer.
Waar kijkt u dan eerst?
Drie oorzaken, drie plekken om te kijken, in deze volgorde. Op een leveranciers-API: verdenk uw eigen prefix. Log per aanroep de tokenaantallen voor cachecreatie en cachelezing, en vergelijk systeemprompt en tooldefinities tussen een goedkope en een dure run voordat u iets anders aanraakt.
Bij zelfgehoste of dedicated serving: verdenk capaciteit in plaats van stilstand. De omvang van de werkset en het evictiebeleid zijn de hefbomen, en een langere TTL koopt niets tegen een mediaan interval van 2,1 seconden. Is de prefix stabiel en de capaciteit ruim, verdenk dan het traject zelf en meet het: zet de kosten per run uit tegen het aantal toolrondes per run. Een lijn die omhoog buigt is de inkortval in uw eigen cijfers, en de remedies zijn de architectuurantwoorden hieronder, nieuw genoeg dat afwachten verdedigbaar is.
Cache-operaties en memory-native modellen: nu invoeren of afwachten?
De architectuurantwoorden kwamen in dezelfde week, en dat is zelf het signaal. AKV stelt twee operaties voor: drop, die geselecteerde cache-entries uitsluit van verdere attention terwijl de trajecttekst onaangeroerd blijft, en repos, die de posities van de resterende keys herschrijft. Beide zijn samen nodig: positie-indices blijven oplopen terwijl een traject groeit, ook nadat de cache kleiner is geworden, zodat een kleine cache alsnog tegen de positielimiet kan lopen. Tegenover de samenvattende basislijn verhoogde tool-responsdrop met repos het slaagpercentage op één benchmark van 56% naar 62% terwijl de kosten daalden van 13,5 naar 10,9 cent. Repos verdient die winst: drop alleen scoorde 55%.
Eén detail is belangrijk voor wie een gateway of proxy beheert: identieke tokenreeksen kunnen verschillende cachetoestanden opleveren afhankelijk van de drophistorie, waardoor gewone prefixvergelijking de verkeerde toestand kan hergebruiken. Cache-identiteit moet de operatiehistorie meenemen, niet alleen de tekst. Dit is een feature van de servingengine en niet van de applicatie: noch de publieke cache van Anthropic noch die van OpenAI biedt iets wat op drop en repos lijkt, dus invoeren op een leveranciers-API kan dit kwartaal niet. Wat overdraagbaar is, is de richting. De gemeten strategie laat juist de oudste toolresponses vallen, houdt de recente vast en herindexeert wat overblijft, het tegenovergestelde van de prompttekstregel hierboven en met opzet: drop verandert de trajecttekst niet en maakt dus geen prefix ongeldig.
De modellaag bewoog ook. MemT-1.0, geplaatst op 19 oktober, bouwt geheugen in de eigen berekening van het model in plaats van keys en values voor elk token te bewaren, en rapporteert ruwweg 66 maal minder persistente opslag dan een volledige-context KV-cache bij een historie van 128K. Lees het als een richting en niet als een vonnis: de samenvatting zegt alleen dat het concurrerend blijft met retrieval-augmented methodes, en er staat geen benchmarktabel bij. Op 20 oktober open-sourcete DeepSeek DeepInfer, het framework achter zijn grootschalige productiediensten, onder Apache 2.0. Lees wel de eigen lijst van wat die release weglaat: het eerste onderdeel dat nodig is voor een complete inferentiedienst en er niet bij zit, is een KV-cachesysteem.
De productlaag leverde zijn eigen antwoord. De release van Notion van 19 oktober tilde het plafond voor één agenttaak naar 24 uur op een herbouwde harness, en meldt los daarvan dat zijn Auto-router Opus 5.5 en Astra evenaart over ruim twintig gangbare taken, tegen ongeveer 90% lagere gemiddelde kosten. Let op welke hefboom Notion voor dat geld aanwijst: elke taak naar een passend goedkoop model routeren, niet cache-economie. Twee van de drie lagen gingen deze week achter de cache aan; de laag met een product ging achter het model aan.
Wat dit verandert voor een Nederlandse IT-organisatie
Drie dingen, waarvoor u geen nieuwe leverancier nodig heeft. Zet kosten per run op het dashboard met een P95 ernaast, in plaats van tokenaantallen. De eenheidsprijs van een agent is niet-deterministisch zoals een licentie per gebruiker dat niet is, en een contract dat in gebruikers is geschreven modelleert dat niet; het agent-observability-argument geldt voor geld even goed als voor traces.
Voeg prefixstabiliteit toe aan uw wijzigingsproces. Het tijdstempelgeval is het sjabloon: een wijziging die elke reviewer doorlaat, met een gemeten kostengevolg. Het hoort op dezelfde checklist als een schemamigratie, en dat zet het in het gesprek met wie uw omgeving beheert. Roept uw agent tools aan over MCP, bedenk dan dat tooldefinities bovenaan de invalidatiehiërarchie staan, dus een serverteam dat zijn eigen toolbeschrijvingen aanpast, past uw rekening aan.
Beslecht daarna de diagnostische splitsing voordat u een remedie koopt. De langere TTL, de samenvatter en de compressiebibliotheek pakken elk een andere oorzaak aan, en twee van de drie meten slechter wanneer ze op de verkeerde oorzaak worden gericht. Dat is een goedkoop uur analyse tegenover vier vijfde van de rekening. De bredere discipline is context engineering; de metingen van deze week zetten er een prijs op als u het verkeerd doet.
Een agentproject van nul begroten is een andere vraag, en wat een AI-project kost is waar wij die beantwoorden; toegepaste AI voor middelgrote organisaties zet uiteen hoe wij naast een bestaande ICT-partner werken. Wat deze week veranderde zijn de exploitatiekosten, en dat is de post die elke maand terugkomt.
Een consultant zegt waar AI loont; Crux Digits bouwt het ook. Vaste prijs per stap, één vaste expert, vanuit Utrecht.
AI-consultancy in Nederland →