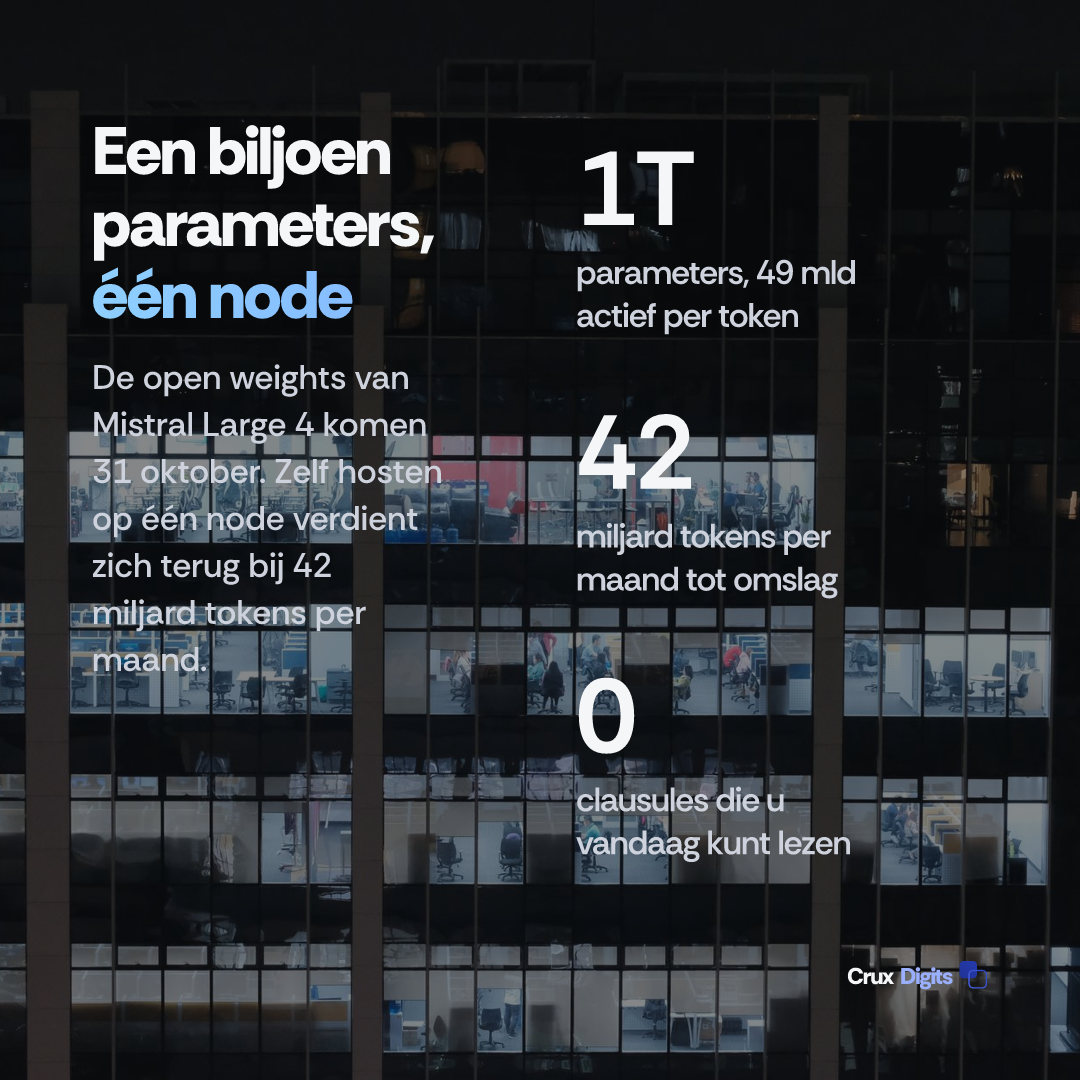
Mistral kondigde Large 4 aan op 6 oktober 2026: een biljoen parameters in totaal, 49 miljard actief per token, getraind in eigen Europese datacenters, met open weights die aan het einde van de maand zouden volgen. Op de modelpagina staat nu een ETA van 31 oktober. De licentietekst bestaat nog niet. Voor een IT-organisatie van 250 tot 5.000 medewerkers beslist geen van beide feiten iets. De rekensom eronder wel.
Wat kondigde Mistral op 6 oktober 2026 precies aan?
De aankondiging van Mistral zelf beschrijft Large 4, publiek bijgenaamd "Le Chonk", als een open-weight mixture-of-experts-model dat instructie en reasoning combineert, met een biljoen parameters in totaal en 49 miljard actief per token, multimodale invoer en meer dan 160 talen, waaronder elke officiële EU-taal. Het is from scratch getraind op 3.800 NVIDIA Grace Blackwell-GPU's in Mistrals eigen Europese datacenters. De lijstprijs van Mistral is $1,36 per miljoen invoertokens en $4,18 per miljoen uitvoertokens; de preview-API op Mistral Studio rekent daar nu de helft van, $0,68 en $2,09, met de lijstprijzen doorgestreept op de prijspagina van Mistral zelf. Ook het parameteraantal moet u twee keer lezen: de aankondiging noemt 52 miljard actieve parameters, terwijl de modelkaart 49 miljard actief per token noemt en 52 miljard inclusief embeddings en outputlagen.
De benchmarklijst is sterk op de plekken die voor engineeringwerk uitmaken: DeepSWE v1.1 op 61,7 procent, Terminal-Bench 4 op 28,3 procent, een Coding Agent Index van 49,8, AutomationBench op 59,9 procent, Cybench op 93 procent en een reproduce-and-patch-score van 82 procent, volgens Mistral de hoogste van de modellen die het vergelijkt. Op de menselijke code-evaluatie van Surge AI komt het op 3,74 van 5, tweede van vijf, achter Claude Opus 5 met 4,22. Op de Dense 200-visietest rapporteert het 42 procent tegen 41 procent voor GPT-6-Astra.
Met de weights is het anders gesteld. De Hugging Face-repository mistralai/Mistral-Large-4-1T-A52B staat er vandaag als aangekondigde release met één regel, "de open weights komen aan het einde van de maand", en een ETA van 31 oktober 2026. Geen bestanden. Geen licentieveld. Eerst nog één opmerking over de prijs: de actie heeft geen gepubliceerde einddatum, dus begroot op de lijstprijs en beschouw $0,68 en $2,09 als een voorwaarde van de preview, niet als een tarief. De sizing-analyse van Qovery van oktober meldt dezelfde splitsing.
Waarom weegt de ontbrekende licentie zwaarder dan de benchmarks?
Omdat "open weight" een uitspraak over distributie is, geen toestemming. En binnen Mistrals eigen Large-lijn is die toestemming beide kanten op gegaan. De modelkaart van Mistral Large 3 noemt expliciet Apache 2.0, voor een model van 675 miljard parameters met 41 miljard actief, uitgebracht in december 2025. Qovery wijst erop dat de Large 2-generatie onder een onderzoekslicentie verscheen die een aparte betaalde commerciële overeenkomst vereiste, en dat Codestral 22B v0.1 een niet-productielicentie heeft. De vraag die een IT-organisatie werkelijk moet beantwoorden (mogen wij dit in productie draaien, op infrastructuur die wij kiezen) heeft dus binnen één productfamilie precedenten aan beide zijden.
Dat telt vanwege wat er aan die licentie hangt. Een leveranciersbeoordeling heeft een veld voor de modellicentie. Een DPIA heeft een benoemde verwerkersketen nodig. Een ISMS-maatregel voor software van derden heeft voorwaarden nodig die u aan een wijzigingsdossier kunt hangen. Geen van die drie sluit u af op een ETA. Een IT-manager kan een pilot starten op een licentie die nog niet gepubliceerd is; een verlenging ondertekenen op zo'n licentie kan niet, en in januari aan een auditor uitleggen wat er in oktober mocht, ook niet. Bij 250 tot 5.000 medewerkers hangt aan die verlenging een inkoopkalender, en dat is het verschil tussen een ongemak en een geblokkeerd kwartaal.
Wat kost het om een biljoen parameters zelf te draaien?
Een mixture-of-experts-model splitst de twee getallen die uitmaken. De 49 miljard actieve parameters bepalen uw throughput en uw kosten per token. De ruwweg 1,05 biljoen in totaal, zoals de sizing-analyses die het geheugenrekenwerk deden het stellen, bepalen uw geheugen, want elke expert moet resident zijn, ook al vuurt er per token maar een fractie. Qovery komt op ruwweg 2,1 TB aan weights bij bf16, 1,05 TB bij FP8 en 525 GB bij 4-bit, plus 10 tot 20 procent voor activaties en fragmentatie en tientallen gigabytes KV-cache bij lange context. Een H100 SXM heeft 80 GB, een H200 SXM 141 GB, dus acht H200's leveren 1.128 GB, wat Qovery bij FP8 krap noemt. De hardwarenotitie van YottaLabs komt op dezelfde ordegrootte uit. De praktische eenheid van zelf hosten is dus één volledige node met acht GPU's, geen losse kaart.
Nu de rekensom die die analyses niet afmaken. Neem één dedicated node tegen het on-demand tarief dat Qovery noemt voor een AWS p5.48xlarge, ongeveer $55,04 per uur, wat bij continu draaien neerkomt op circa $40.000 per maand. Neem de lijstprijs van de API en een verhouding van vier invoertokens op één uitvoertoken, wat uitkomt op ongeveer $1,92 per miljoen tokens gemengd. Het omslagpunt ligt dan rond 20,8 miljard tokens per maand, oftewel ruwweg 7.900 tokens per seconde onafgebroken over een maand van 730 uur. En dat is nog de gunstige rekensom: tegen de $0,68 en $2,09 die de preview werkelijk rekent, moet dezelfde node zo'n 41,8 miljard tokens per maand verwerken, bijna 15.900 tokens per seconde, elk uur, ook 's nachts en in de week tussen Kerst en Nieuwjaar. Verschuif de tokenverhouding en het getal beweegt wat; verschuif de prijsaanname en het verdubbelt. Een ordegrootte beweegt het niet. Qovery komt van de andere kant tot dezelfde slotsom en legt het omslagpunt boven ruwweg 20 tot 40 procent aanhoudende bezetting. Geen organisatie van 250 tot 5.000 medewerkers zit vandaag in de buurt van een van beide cijfers met haar AI-werklast.
Wie zag de ontbrekende licentie al, en wat lieten zij liggen?
Het argument dat het contract zwaarder weegt dan de vlag is niet van mij. Op 8 september 2026 betoogde beri.net, naar aanleiding van Mistrals Series D van 3 miljard euro onder leiding van Samsung, dat nationaliteit een zwakke soevereiniteitsmaatregel is omdat een financieringsronde die kan veranderen zonder dat één klantcontract verandert. Het stelt voor om in plaats daarvan vier contractuele maatregelen te scoren. De tweede daarvan is hier de relevante: of een model beheersbaar is, toetst u aan de modellicentie, niet aan de vraag of de weights te downloaden zijn.
Dat stuk ging over de Mistral 3-generatie, waar elk model in de lijn een benoemde licentie had (Apache 2.0 op Large 3, een aangepaste MIT met een omzetdrempel op andere), zodat de maatregel in elk geval te beantwoorden viel. Dezelfde auteurs pasten hem op 6 oktober toe op Large 4 en liepen vast, en de ontbrekende licentie is inmiddels de gangbare lezing van deze release: orcarouter wijst erop dat de licentiecel in Mistrals eigen modelkeuzegids simpelweg leeg is, en dat Artificial Analysis de licentie als null registreert, het model niet als open-weight markeert en het als proprietary indeelt. Het gat signaleren is dus niet de bijdrage van dit stuk, en wie u vertelt van wel, heeft de berichtgeving van deze week niet gelezen. De licentiestukken dekken het juridische gat en de sizing-analyses dekken het hardwareantwoord. Wat niemand deed, is het alternatief doorrekenen, en alleen dat vertelt een organisatie zonder GPU-park wat dat gat haar werkelijk kost.
Als de weights geen implementatieplan zijn, wat zijn ze dan?
Twee dingen die het waard zijn om te hebben, en waarvoor u geen hardware nodig heeft. Het eerste is een uitweg. Veranderen de voorwaarden, de prijs of de regionale beschikbaarheid van de API, dan betekent een gelicentieerd checkpoint dat een derde partij dezelfde weights voor u kan serveren: uw prompts, uw tooldefinities en uw evaluatieset verhuizen, en het model eronder hoeft niet opnieuw gebouwd te worden. Dat is hetzelfde argument als de evals zelf houden en de bouw uitbesteden, een laag dieper toegepast.
Het tweede is een prijsplafond. Een gepubliceerd checkpoint dat concurrerende Europese hosts kunnen serveren legt een bovengrens op wat de API van de leverancier zelf kan vragen, en dat is de structurele reden dat open weights uitmaken voor inkopers die ze nooit zullen draaien. Onze eerdere analyse van open-weight versus betaalde modellen maakte het algemene punt; bij Large 4 ligt dat plafond een stuk hoger in de prestatiecurve. Beide voordelen hangen volledig af van een licentie die commercieel gebruik en hosting door derden toestaat. Precies die clausule kan nog niemand lezen.
Welke soevereiniteitsvraag beantwoordt het contract, en welke het checkpoint?
Scheid ze, want ze worden anders ingekocht. Het contract beantwoordt waar de verwerking plaatsvindt, wie de subverwerkers zijn, welk recht geldt, en welke audit- en verwijderingsrechten u heeft. Mistral stelt dat zijn Europese deployment end to end door Mistral zelf wordt uitgevoerd, onafhankelijk van andere digitale dienstverleners en onder Europees recht. Dat is een contractuele claim, en een contractuele claim toetst u in een contract, en daar hoort een informatiemanager die te toetsen.
Het checkpoint beantwoordt één nauwere vraag: kan dit model draaien zonder enig netwerkpad naar de leverancier. Dat is een echte eis voor een kleine verzameling workloads, en Mistral noemt security operations als het geval voor zelf deployen. Voor de gewone mkb+-workload (documentzoeken, een assistent op de servicedesk, hulp bij calculaties, een privéassistent op eigen data) is het contract het instrument en is het checkpoint niet aan de orde. De fout om te vermijden: het checkpoint-verhaal kopen voor een workload die het contract nodig had, en het jaar eindigen met GPU-budget en geen antwoord voor de auditor.
Wat moet een Nederlandse IT-organisatie vóór 31 oktober besluiten?
Vier besluiten, en het is de moeite om te benoemen wie elk daarvan bezit, want in een Nederlands mkb+-landschap liggen ze bij verschillende partijen. Twee zijn van u. Ten eerste: mag een pilot starten op een preview-API zonder gepubliceerde licentie. Meestal wel, als de data erin niet gevoelig is en de uitweg in de pilot staat en niet pas bij de verlenging. Ten tweede: welke van uw workloads werkelijk geen netwerkpad naar een leverancier verdraagt. Maak die lijst nu, voordat de weights landen en het gesprek spannend wordt; hij is vrijwel altijd korter dan de zaal verwacht.
Het derde besluit ligt bij uw ICT-partner, en het eerlijke antwoord is dat uw ICT-partner dit niet gaat hosten. Een node met 1,1 TB GPU-geheugen staat niet in een Nederlandse catalogus voor managed services, en erom vragen maakt van een modelkeuze een datacenterproject. Hun echte vraag is nauwer en het stellen waard: egress, identiteit en logging voor het endpoint dat u uiteindelijk wél aanroept. Het vierde ligt bij wie de toepassing bouwt: prompts, tooldefinities en de evaluatieset in uw eigen repository houden, zodat het model het vervangbare deel blijft. Dat is het hele uitgangspunt achter onze aanpak van AI-implementatie in Nederland en de reden dat toegepaste AI voor middelgrote organisaties begint bij uw bestaande leverancierslandschap en niet bij een modelkeuze.
Lees op 31 oktober vervolgens eerst drie dingen in de licentie: of commercieel gebruik is toegestaan, of hosting door derden is toegestaan, en of bijgetrainde afgeleiden mogen worden verspreid. Staan alle drie open, dan zijn de uitweg en het prijsplafond beide echt. Is een ervan voorwaardelijk aan omzet of aan een aparte overeenkomst, dan heeft u opnieuw het Large 2-patroon, en verdwijnt het plafond daarmee. Hoe wij modellen kiezen voor een workload verandert hoe dan ook niet: één score is geen bewijs, en één licentie is geen strategie.
Laatst bijgewerkt: 16 oktober 2026.
Wij bouwen maatwerk-AI en LLM-systemen die in productie draaien: een klikbare MVP bij het tweede gesprek, vaste stappen, en de code is van u.
AI-ontwikkelbureau in Nederland →