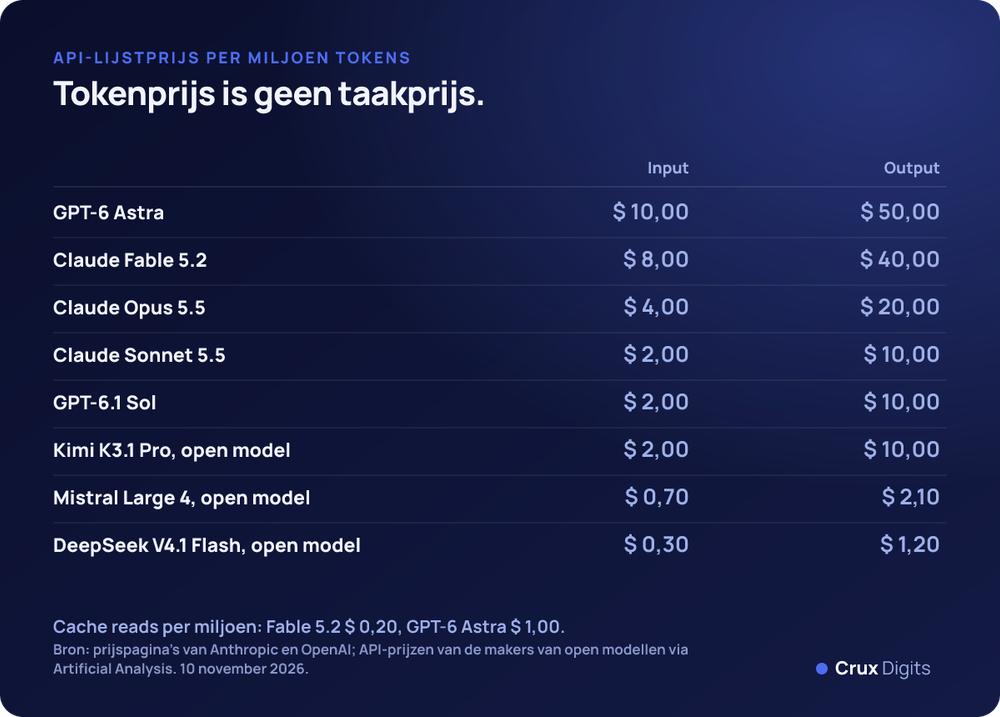
Anthropic bracht Claude Fable 5.2 uit op 9 november 2026, samen met Claude Mythos 5.2: hetzelfde model met minder beveiligingen, alleen voor gescreende organisaties in security en life sciences. De lijstprijs daalde naar $ 8 per miljoen input-tokens en $ 40 per miljoen output, van $ 10 en $ 50 voor Fable 5.1. Volgens Anthropic is de output tot 30 procent sneller. Het contextvenster blijft 1 miljoen tokens, met maximaal 128.000 tokens output. De cijfers staan in de aankondiging van Anthropic en op de prijspagina van Claude.
De kop van de lancering is een bewijs. Volgens Anthropic formaliseerden 1.000 agents met Fable 5.2 de laatste stelling van Fermat in ongeveer 30 uur, waar de eerste formalisering 11 dagen kostte. Opus 5.5 kwam in dezelfde opzet in 18 uur tot 26 procent. Dat is een demonstratie van de leverancier, geen benchmark die u kunt herhalen. Voor een IT-afdeling zijn de vragen concreter: waar loopt 5.2 echt voor, wat kost een taak, en hoe dicht zitten GPT-6 Astra en de open modellen erbij.
De eigen tabel van Anthropic: waar Fable 5.2 wint en waar niet
Anthropic zet Fable 5.2 naast Fable 5.1, Claude Opus 5.5, GPT-6 Astra en Gemini 4 Carbon, elk op de hoogste beschikbare effort tenzij anders vermeld. Op de meeste regels wint Fable 5.2:
- FrontierCode 2.0, agentisch programmeren: 49,1 procent, tegen 45,5 voor Opus 5.5, 42,8 voor GPT-6 Astra, 41,1 voor Gemini 4 Carbon en 32,4 voor Fable 5.1.
- FrontierSWE v2: 69,9 procent, tegen 65,5 voor Astra en 62,3 voor Opus 5.5.
- OSWorld 2.1, computergebruik: 89,3 procent, tegen 87,2 voor Opus 5.5 en 79,5 voor Astra.
- Humanity's Last Exam met tools: 74,2 procent, tegen 67,7 voor Opus 5.5 en 57,2 voor Astra.
- Remote Labor Index: 41,3 procent, tegen 21,3 voor Opus 5.5 en 20,8 voor Astra. Een van de grootste sprongen in de tabel, ongeveer een verdubbeling.
Twee regels gaan de andere kant op. Op AutomationBench, dat bedrijfsprocessen over meerdere tools test, scoort Gemini 4 Carbon 53,9 tegen 51,4 voor Fable 5.2. Op de Elo-score van AA-Briefcase voor kenniswerk haalt Opus 5.5 1.800 tegen 1.785. Gaat het u om procesautomatisering over SaaS-pakketten heen, dan zegt de tabel van de leverancier zelf al: test meer dan één model.
Wat onafhankelijke tests laten zien
Een leverancier kiest zijn eigen benchmarks. Twee onafhankelijke partijen hadden binnen een dag na de lancering scores.
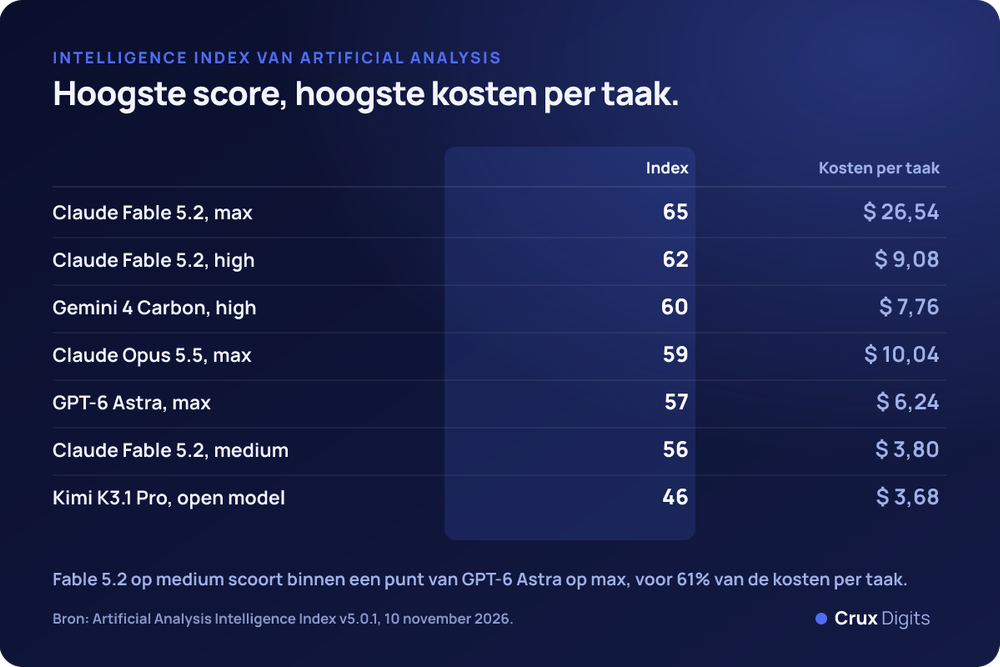
Artificial Analysis zet Fable 5.2 op maximale effort bovenaan de Intelligence Index v5.0.1, met 65. Daarna volgen Gemini 4 Carbon op high met 60, Opus 5.5 op max met 59 en GPT-6 Astra op max met 57. Het beste open model, Kimi K3.1 Pro, scoort 46.
Vals AI zet Fable 5.2 op de eerste plaats van 36 in de Vals Index, met 71,31 procent op high effort. De nummers twee en drie zijn de verrassing: Claude Sonnet 5.5 met 70,85 en Gemini 4 Carbon met 70,45. Sonnet 5.5 zit minder dan een half punt lager, voor een kwart van de lijstprijs van Fable. GPT-6 Astra scoort 65,02 en staat zevende.
De onafhankelijke resultaten laten ook zien waar Fable 5.2 niet voorop loopt:
- Vals Science Index: GPT-6 Astra 65,09 procent, Fable 5.2 63,74.
- Terminal-Bench-Science bij Vals: Astra 62,86 procent, Fable 5.2 55,71. In de eigen run van Anthropic op versie 0.1 lag Fable voor, 74,6 tegen 68,1. De testopzet bepaalt hier de winnaar.
- SWE-bench Multimodal bij Vals: Opus 5.5 70,21 procent, Fable 5.2 62,29.
Lijstprijs tegenover kosten per taak
Per token is Fable 5.2 voordeliger dan GPT-6 Astra, dat $ 10 input en $ 50 output kost volgens de prijspagina van OpenAI. Per taak is het andersom. Artificial Analysis mat $ 26,54 per taak in de Intelligence Index voor Fable 5.2 op max, tegen $ 6,24 voor Astra op max: 4,3 keer zoveel. De oorzaak is volume. Fable 5.2 schreef 275 miljoen output-tokens over de hele index, tegen een mediaan van 72,8 miljoen voor modellen in dezelfde klasse.
Het geld zit in de effort-instelling. Dezelfde index over de niveaus van Fable 5.2:
- Low: 54, voor $ 3,10 per taak.
- Medium: 56, voor $ 3,80.
- High: 62, voor $ 9,08.
- Xhigh: 62, voor $ 14,83.
- Max: 65, voor $ 26,54.
Daar volgen drie dingen uit. Medium scoort binnen één punt van GPT-6 Astra op max, voor 61 procent van de kosten per taak van Astra. High scoort gelijk aan xhigh voor 61 procent van de kosten. En high verslaat Opus 5.5 op max, 62 tegen 59, voor iets minder geld. Anthropic laat hetzelfde zien op de eigen programmeerbenchmark: op high scoort Fable 5.2 45,3 procent op FrontierCode, gelijk aan de beste score van Opus 5.5, voor ongeveer de helft van de kosten per taak. VentureBeat meldt op basis van de system card dat max effort 45,7 procent haalde voor $ 44,70 per taak, lager dan xhigh met 49,1 procent voor $ 14,19. Meer effort geeft dus niet altijd een beter antwoord.
Voor agents telt één regel op de rekening zwaarder dan de lijstprijs: gecachete input. Fable 5.2 rekent $ 0,20 per miljoen cache-read-tokens, GPT-6 Astra $ 1,00. Neem één agentbeurt met 120.000 tokens gecachete context, 2.000 nieuwe input-tokens en 1.000 output-tokens:
- Fable 5.2: $ 0,024 cache read, $ 0,016 input en $ 0,040 output, samen $ 0,080 per beurt.
- GPT-6 Astra: $ 0,120, $ 0,020 en $ 0,050, samen $ 0,190 per beurt.
- Ter vergelijking Fable 5.1: $ 0,100 per beurt.
Bij gelijke aantallen tokens kost een beurt met Astra 2,4 keer zoveel. Astra haalt dat alleen in als het dezelfde klus in minder beurten afmaakt, en dat meet u op uw eigen taken. Hetzelfde rekenvoorbeeld voor Fable 5.1 staat in onze vergelijking met GPT-6 Astra.
Open modellen: het verschil hangt af van de test
Op de brede index is het verschil groot. Kimi K3.1 Pro van Moonshot, uitgebracht op 23 oktober, scoort 46 bij Artificial Analysis tegen 65 voor Fable 5.2: 19 punten verschil. De andere open modellen aan de top zitten verder terug:
- DeepSeek V4.1 Flash: 33, MIT-licentie, $ 0,60 per taak in de index.
- GLM-5.3 van Z.ai: 32.
- Mistral Large 4, uit Frankrijk en uitgebracht op 29 oktober: 26, het hoogst scorende Europese open model.
- Qwen3.8 27B: 20, Apache 2.0, een dense model van 27 miljard parameters met een context van 256.000 tokens.
Op agentisch werk in de terminal is het verschil bijna weg. In Terminal-Bench 4.0 van Vals scoort Kimi K3.1 Pro 63,64 procent, tegen 65,15 voor Fable 5.2 en 59,60 voor GPT-6 Astra. Artificial Analysis zet Kimi op dezelfde benchmark zelfs bovenaan, met 67,2. Kimi kost $ 2 input en $ 10 output per miljoen tokens en $ 3,68 per taak in de index.
Controleer twee dingen voordat u open modellen als de soevereine route ziet. Eerst de licentie. Kimi K3.1 Pro heeft een eigen licentie die commercieel gebruik toestaat met beperkingen, en voor Mistral Large 4 is een commerciële licentie nodig als u het als gehoste dienst aanbiedt. DeepSeek V4.1 Flash (MIT) en Qwen3.8 (Apache 2.0) zijn de ruime licenties. Dan de omvang. Kimi K3.1 Pro heeft 2,8 biljoen parameters, waarvan 104 miljard actief. Het sterkste open model in uw eigen omgeving draaien is dus een project voor een GPU-cluster, niet voor één server. Die afweging staat in open modellen tegenover betaalde modellen.
Welk model voor welk werk
Geen enkel model wint elke regel. Kies dus per werksoort en houd die keuze instelbaar:
- Lange, zelfstandige programmeer- en agenttaken waarbij een mislukte run duur is: Fable 5.2 op high. Ga alleen naar xhigh waar uw eigen tests winst laten zien.
- Procesautomatisering over SaaS-pakketten: test Gemini 4 Carbon naast Fable 5.2, omdat dat model AutomationBench aanvoert.
- Grote volumes goed afgebakend werk: Claude Sonnet 5.5, binnen een half punt op de Vals Index voor een kwart van de prijs, of GPT-6.1 Sol, dat 55 scoort bij Artificial Analysis voor $ 1,27 per taak.
- Wetenschappelijk en analytisch werk: neem GPT-6 Astra mee, dat de Vals Science Index aanvoert.
- Data die uw omgeving niet mag verlaten: een open model, DeepSeek V4.1 Flash voor een ruime licentie of Kimi K3.1 Pro als de licentievoorwaarden passen.
Test daarna op uw eigen werk. Vijftig tot honderd echte taken uit uw tickets, documenten of repositories, beoordeeld zoals uw team ze zou beoordelen, zeggen meer dan elke tabel in dit artikel. Log bij elke aanroep het model-ID en het effort-niveau, want effort-labels zijn tussen leveranciers niet vergelijkbaar. Hoe u die routering inricht, staat in een model kiezen per type agentwerk. Crux Digits in Utrecht bouwt die testset uit het eigen materiaal van een klant voordat er een model wordt gekozen. Een nieuwe release is dan een aanpassing in de configuratie, geen herbouw.
Hoe u deze cijfers leest
Bij elk cijfer hoort een kanttekening:
- De effort-instellingen verschillen. Anthropic meldt elk model op de hoogste beschikbare effort, Artificial Analysis noemt Fable 5.2 op max als kopcijfer en Vals testte op high.
- Het model is een dag oud. Fable 5.2 staat nog niet in de top tien van het agent-klassement van Arena, en de onafhankelijke scores bewegen nog als er meer runs bijkomen.
- Benchmarkversies tellen mee. Vals heeft SWE-bench Verified gearchiveerd omdat het verzadigd is, dus oudere programmeerscores zijn niet vergelijkbaar met FrontierCode of Terminal-Bench 4.0.
- De kosten per taak die VentureBeat noemt, komen uit de system card van Anthropic zoals VentureBeat die weergeeft.
Cijfers zoals gepubliceerd op 10 november 2026.
Wij bouwen maatwerk-AI en LLM-systemen die in productie draaien: een klikbare MVP bij het tweede gesprek, vaste stappen, en de code is van u.
AI-bureau in Nederland →