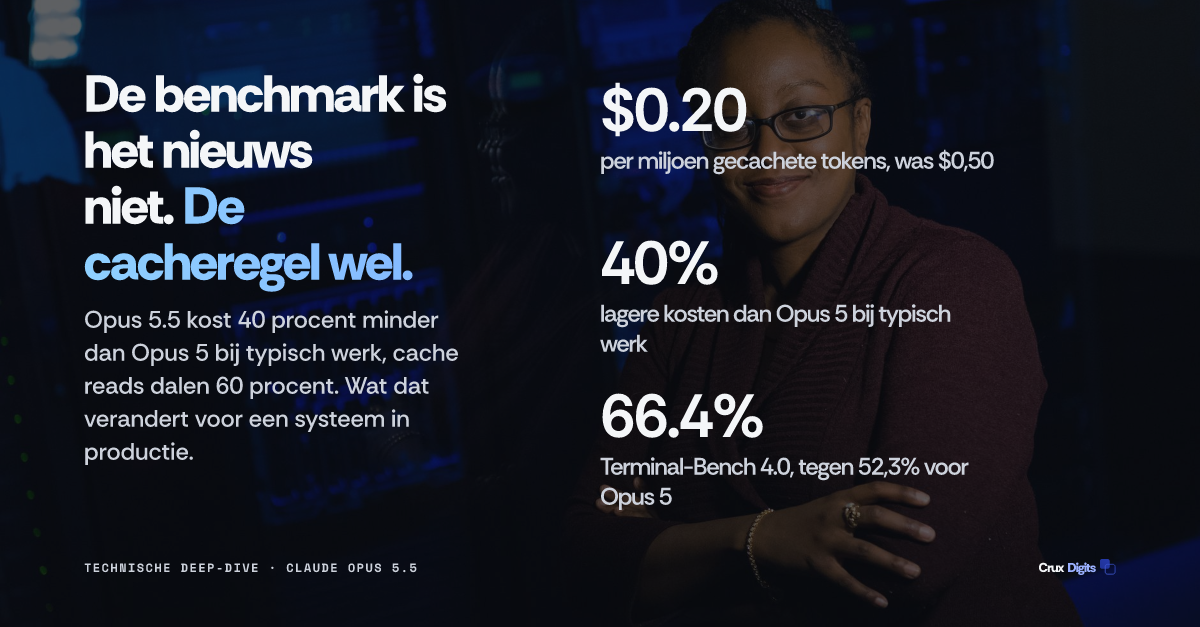
Anthropic bracht Claude Opus 5.5 uit op 22 september 2026. De meeste berichtgeving opende met benchmarkscores. Voor een bedrijf dat al AI in productie heeft, is die benchmarktabel het minst interessante deel van de aankondiging. Het nieuws zit in de prijslijst.
Wat er is aangekondigd
Opus 5.5 is het eerste model in de Claude 5.5-familie. Anthropic positioneert het als: op het niveau van Claude Fable 5.1 voor het meeste werk, en bij standaardinstellingen 40% goedkoper in gebruik dan Opus 5. Sonnet 5.5 en Haiku 5.5 volgen volgens de aankondiging in de weken erna.
De gepubliceerde prijzen per miljoen tokens, naast Opus 5: invoertokens $4 tegen $5, uitvoertokens $20 tegen $25, cache writes $5 tegen $6,25 en cache reads $0,20 tegen $0,50. Uitvoer wordt meer dan 30% sneller gegenereerd. Er is een fast mode voor $8 per miljoen invoer- en $40 per miljoen uitvoertokens. Dit zijn allemaal cijfers van Anthropic zelf.
De prijs is het nieuws, en de cacheregel is de reden
Invoer is 20% goedkoper en uitvoer is 20% goedkoper, maar cache reads zijn 60% goedkoper. Juist die regel beweegt een productierekening, want bij agent- en retrievalwerk vormen cache reads het grootste deel van de kosten. Elke tool-aanroep speelt de context opnieuw af. Elke stap van een agent leest dezelfde systeemprompt, hetzelfde schema en dezelfde opgehaalde documenten opnieuw.
Een assistent die uw eigen documenten doorzoekt, bestaat vooral uit cache reads. Een agent die plant, een tool aanroept, het resultaat leest en opnieuw plant, bestaat vooral uit cache reads. Heeft uw werk die vorm, dan onderschat die 40% wat er met uw factuur gebeurt, en de besparing komt binnen zonder dat u een regel code aanraakt.
Er is een tweede effect dat gemakkelijk over het hoofd wordt gezien. Anthropic meldt dat het model minder tokens per taak gebruikt, niet alleen dat tokens goedkoper zijn. In een van hun voorbeelden auditte en herstelde een tester een codebase van 200.000 regels in minder dan drie uur, tegenover ruim 20 uur en 2,5 keer zoveel tokens op Opus 5. Prijs per token en tokens per taak werken op elkaar in, en daar komt die 40% vandaan.
Wat de benchmarks wel en niet zeggen
Op de gepubliceerde cijfers leidt Opus 5.5 op agentic coding (Terminal-Bench 4.0: 66,4%, tegen 55,8% voor Fable 5.1 en 52,3% voor Opus 5), op kenniswerk (GDPval-AA v2.1: 1846, tegen 1735 en 1708) en op computergebruik (OSWorld 2.0: 81,8% partial). Op Terminal-Bench-Science scoort het 58,7% waar GPT-6 Astra 64,6% haalt, dus de voorsprong is niet overal.
De nuttigste zin in de aankondiging is het voorbehoud. Anthropic schrijft zelf dat benchmarkmarges op dit niveau een minder betrouwbare gids zijn voor verschillen in de praktijk, en dat het gat tussen Opus 5.5 en Fable 5.1 in hun eigen gebruik kleiner is dan de scores suggereren. Een leverancier die de grenzen van zijn eigen scorebord opschrijft, is meer waard dan dat scorebord.
Behandel de tabel als een reden om zelf te testen, niet als een uitkomst. De enige benchmark die iets beslist voor uw bedrijf, is die van uw eigen gevallen, met uw eigen documenten, beoordeeld door de mensen die met de uitkomst moeten werken.
Wat er verandert als u al iets in productie heeft
Vijf dingen zijn de moeite waard in de week na elke grote modelrelease, en geen daarvan is een herbouw.
Ten eerste: controleer of u een modelversie hebt vastgezet. Noemt uw code een modelfamilie in plaats van een versie, dan kan gedrag onder u veranderen zodra een leverancier een standaard verschuift. Vastzetten is hoe u zelf bepaalt wanneer u meegaat, in plaats van het te horen via een supportticket.
Ten tweede: draai uw eigen acceptatieset opnieuw voordat u iets omzet. Heeft u die niet, dan is dat de bevinding. Vijftig tot tweehonderd echte gevallen met de antwoorden die u verwacht, is de goedkoopste verzekering in toegepaste AI en maakt van een modelrelease een meting in plaats van een gerucht.
Ten derde: meet tokens per taak, niet de prijs per token. Een model dat per token minder kost maar meer stappen neemt, is in de praktijk duurder. Andersom geldt net zo goed, en dat is de richting die Anthropic hier claimt.
Ten vierde: kijk wat een wissel doet met uw papieren spoor. Valt uw systeem onder de AI Act, dan hoort het model bij de technische documentatie die u bijhoudt, en is wisselen een wijziging die u vastlegt in plaats van een stille upgrade. De transparantieplicht uit artikel 50 geldt vanaf 2 augustus 2026 en de hoog-risicoverplichtingen uit Annex III vanaf 2 december 2027, volgens de Digital Omnibus-planning.
Ten vijfde: beslis op bewijs. Wissel wanneer uw eigen set zegt dat het nieuwe model minstens even goed is en de kosten per taak lager zijn. Blijf wanneer dat niet zo is. Beide antwoorden zijn prima, en geen van beide vraagt om een herbouw van het systeem rond het model.
Wat een modelupgrade niet oplost
Een sneller en goedkoper model maakt uw data niet schoon, documenteert uw proces niet en bepaalt niet welke uitzondering een mens moet afhandelen. In de projecten die wij zien, beslissen juist die drie of een systeem dagelijks gebruikt gaat worden, en een release verandert daar niets aan.
Het patroon werkt ook de andere kant op. Geeft een assistent een onbetrouwbaar antwoord omdat het brondocument verouderd is, dan geeft een beter model u een vlotter onbetrouwbaar antwoord. De kwaliteit van retrieval, het eigenaarschap van de content en een duidelijke overdracht naar een mens bepalen dat cijfer, en dat is werk dat u één keer doet in plaats van elke release.
Kort samengevat
Opus 5.5 is een echte stap vooruit op agentwerk en een echte daling van de gebruikskosten, met de grootste besparing in de regel waar bijna niemand naar kijkt. Heeft u iets in productie: zet uw versie vast, draai uw eigen set opnieuw, meet tokens per taak en leg de wijziging vast. Heeft u nog niets draaien, dan is een modelrelease geen reden om te beginnen; een proces dat u meetbaar tijd kost, is dat wel.
De cijfers in dit artikel komen van Anthropic zelf, gepubliceerd op 22 september 2026 bij de aankondiging van Opus 5.5. De benchmarkresultaten zijn door de leverancier gerapporteerde cijfers en geen metingen van ons.
Wij bouwen maatwerk-AI en LLM-systemen die in productie draaien: een klikbare MVP bij het tweede gesprek, vaste stappen, en de code is van u.
AI-ontwikkelbureau in Nederland →