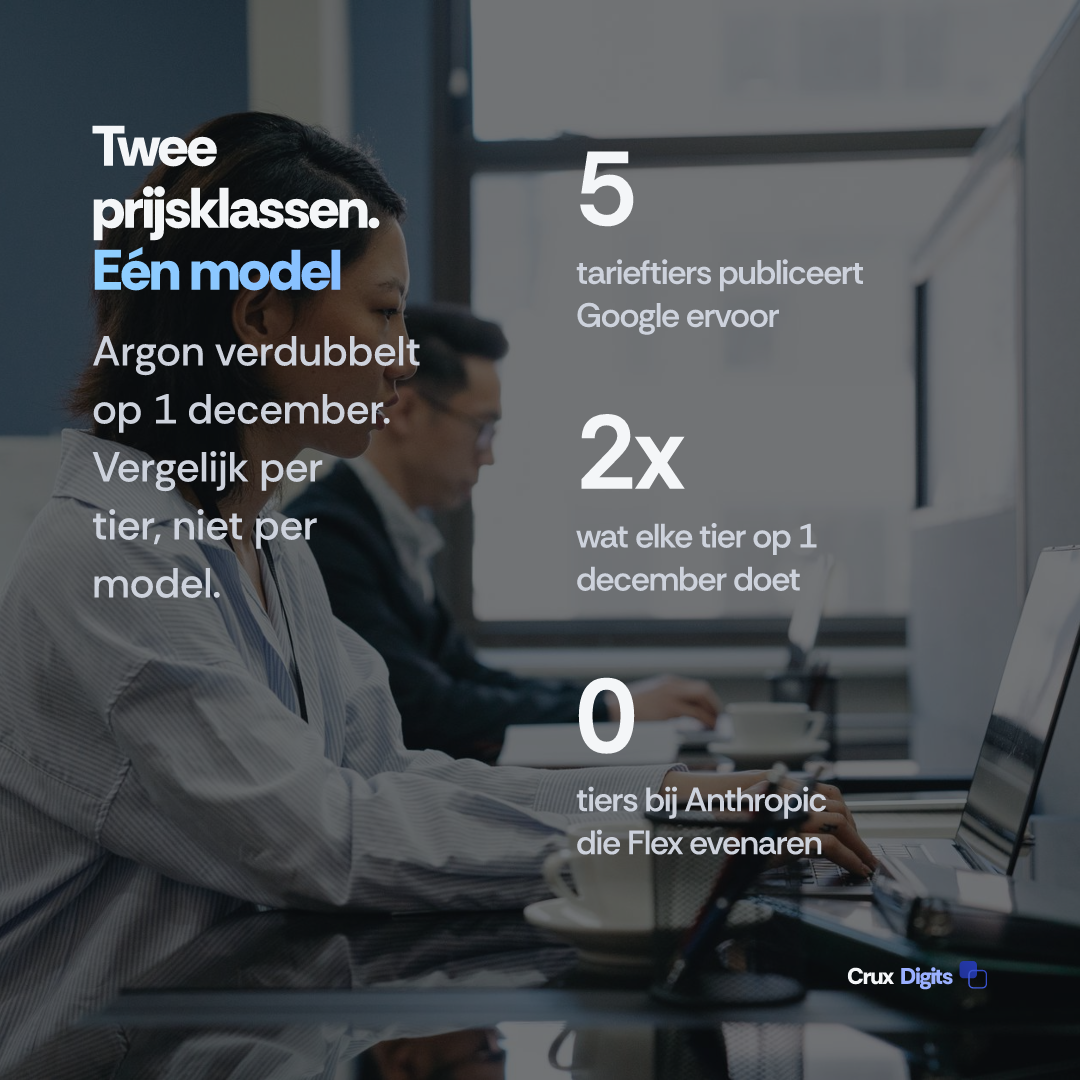
Google maakte Gemini 4 Argon op 13 oktober 2026 algemeen beschikbaar tegen een introductietarief dat tot en met 30 november loopt. Op 1 december verdubbelt elk Argon-tarief. Het model verandert niet; de prijsklasse wel, van waar Anthropic Claude Sonnet 5.5 noteert naar waar het Claude Opus 5.5 noteert. De vraag die een begroting echt beantwoord wil zien is welke van Googles vier open tarieftiers u doorrekent, want Anthropic publiceert er twee plus een premiummodus.
Dit is geschreven voor degene die een bedrag in een begrotingsregel voor 2027 moet zetten: de IT-manager, informatiemanager, IT-directeur of architect bij een Nederlandse organisatie van 250 tot 5.000 fte, die een modelkeuze moet goedkeuren op een prijs die over zes weken vervalt.
Wat verandert er op 1 december 2026?
Argon is het multimodale vlaggenschip van Google. Het werd op 30 september 2026 gepresenteerd via het Fairwind Program, met toegang beperkt tot goedgekeurde cybersecurityverdedigers, en werd op 13 oktober algemeen beschikbaar. Op de prijspagina van de Gemini API staat het standaardtarief tot en met 30 november 2026 op $2 per miljoen inputtokens en $10 per miljoen outputtokens, daarna op $4 en $20. Gecachete input gaat van $0,10 naar $0,20. Outputprijzen zijn inclusief thinking-tokens.
Dat het decembertarief precies samenvalt met de lijstprijs van Claude Opus 5.5, en het introductietarief precies met die van Claude Sonnet 5.5, is al eerder opgeschreven. Een vergelijking die op 14 oktober is bijgewerkt zette beide op een rij, inclusief de batchregel. Die constatering claimen wij niet, en diezelfde vergelijking bevat ook de Priority-regel en het contrast tussen impliciete en expliciete caching. Een vergelijking van 15 oktober zet inmiddels ook de premiumfactor van Google van 1,8 naast die van Anthropic van 2. Wat wij nergens samengesteld hebben gevonden is de Flex-sport naast de ladder van Anthropic, en daar zit de tierbeslissing.
Hoe verhouden de tiers van Argon zich tot die van Claude?
Google publiceert vijf tarieftiers voor Argon, waarvan er vier voor iedereen open staan. De vijfde, Contributor, is een private preview op uitnodiging met de prijs van Batch, en het is de enige tier waarvan Google zegt het verkeer te gebruiken om zijn producten te verbeteren, wat in uw verwerkingsregister hoort. Anthropic publiceert twee tiers voor Opus 5.5 plus een premiummodus. Per miljoen tokens, input en output, deze week geverifieerd tegen de eigen pagina's van beide leveranciers:
- Standaard. Argon $2/$10 nu, $4/$20 vanaf 1 december. Opus 5.5 staat op $4/$20 en Sonnet 5.5 op $2/$10, beide ongewijzigd.
- Batch. Argon $1/$5 nu, $2/$10 vanaf 1 december. De batchprijs van Opus 5.5 is $2/$10 en die van Sonnet 5.5 $1/$5. Vanaf december is Argons batchtarief gelijk aan zowel het batchtarief van Opus 5.5 als het standaardtarief van Sonnet 5.5.
- Flex. Argon $1/$5 nu, $2/$10 vanaf 1 december. Anthropic publiceert geen equivalent, dus een workload die wisselende latency verdraagt heeft bij de ene leverancier een sport op de ladder en bij de andere niets om mee te vergelijken.
- Priority. Argon $3,60/$18 nu, $7,20/$36 vanaf 1 december. Het dichtstbijzijnde bij Anthropic is fast mode op $8/$40, en dat is geen gelijk product. Let op de factoren: de premiumtier van Google is 1,8 keer het eigen standaardtarief, die van Anthropic 2 keer het eigen standaardtarief.
- Gecachete input. Argon staat op $0,10 en daarna $0,20 bij Standaard, $0,05 en daarna $0,10 bij Batch en Flex, en $0,18 en daarna $0,36 bij Priority. Cache-reads van Opus 5.5 kosten $0,20, die van Sonnet 5.5 $0,10.
Lees die lijst van boven naar beneden, niet één regel van links naar rechts. Argon is niet simpelweg de helft van Opus 5.5 tot december en daarna gelijk. Het bezet op elke vergelijkbare tier de volledige prijsklasse van Sonnet 5.5, daarna de volledige klasse van Opus 5.5, en het heeft twee sporten die bij Anthropic geen tegenhanger kennen. Een inkoopvergelijking die het ene standaardtarief tegen het andere zet, vergelijkt een kwart van het prijsoppervlak.
Waarom kunt u het cachetarief op Argon niet zelf inrichten?
Omdat Argon alleen impliciete caching ondersteunt. Expliciete context caching wordt voor dit model niet ondersteund, wat de prijspagina van Google met zoveel woorden vermeldt. De korting van 95 procent op gecachete input krijgt u dus wanneer prefixen toevallig herhalen, niet omdat u hem inricht.
Bij Anthropic werkt het andersom. U betaalt om een cache te schrijven, $5 per miljoen tokens voor een levensduur van vijf minuten en $8 voor een uur bij Opus 5.5, en leest hem daarna voor $0,20. Dat is een kostenpost die u bewust maakt en een hitrate die u stuurt. De cacheregel hierboven is daarmee de enige regel in de tabel die geen gelijke vergelijking is: de ene leverancier verkoopt u een cache, de andere geeft u er een als het zo uitkomt.
Het weegt het zwaarst bij het type workload dat een middensegmentteam meestal als eerste pilot draait: retrieval over een lange, stabiele systeemprompt. Bij Claude kunt u die prompt in een cache inrichten en weten wat de hitrate wordt. Bij Argon schrijft u de prompt, kijkt u wat de impliciete cache doet, en begroot u het volle tarief tot de logs iets anders laten zien.
Zijn de onafhankelijke benchmarks het eens met die van Google?
Niet overal, en het verschil loopt in een richting die de aandacht waard is.
Op de eigen gepubliceerde vergelijkingen van Google gaat Argon voorop: DeepSWE v1.1 op 77,9 procent tegen 74,2 voor Opus 5.5 en 74,1 voor GPT-6 Astra; de Harvey-benchmark voor juridisch werk op 19,6 tegen 3,8 en 5,4; Zapier AutomationBench op 51,3 tegen 42,5 en 41,4; de Vals-index bij lancering op 68,9 tegen 67,0 voor Opus 5.5. Dit zijn agentic- en tool-usebenchmarks, en bij twee ervan zijn de marges groot.
Op de onafhankelijke index draait de volgorde om. Artificial Analysis vat de release op als de terugkeer van Google in de top drie van labs. Uit de indexcijfers leest The Decoder Argon (High) op 53, gelijk met GPT-6 Astra (max) en Claude Fable 5.1, achter Claude Opus 5.5 op 58 en Claude Sonnet 5.5 op 56. Wij kennen er geen plaats aan toe, omdat de gepubliceerde weergaven de gelijke standen verschillend tellen; de scores zijn het deel dat standhoudt. De Vals-index is sindsdien verschoven: op 19 oktober staat Sonnet 5.5 eerste op 70,85, Opus 5.5 tweede op 70,18 en Argon derde op 69,24.
Dan de benchmark die twee keer kijken waard is. Google publiceerde Terminal-Bench 4.0 in het eigen evaluatierapport op 57,4 procent voor Argon tegen 66,4 voor Opus 5.5, 58,2 voor GPT-6 Astra en 57,9 voor Claude Fable 5.1, waarmee Argon in de grafiek van zijn eigen leverancier als laatste van vier eindigt. Artificial Analysis draaide dezelfde benchmark en kwam uit op 57 voor Argon, 59 voor GPT-6 Astra, 60 voor Opus 5.5 en 64 voor Sonnet 5.5: opnieuw Argon als laatste. Het nuttige detail is welk getal beweegt. Argon scoort op beide metingen ongeveer 57. Opus 5.5 scoort 66,4 in de grafiek van Google, dezelfde 66,4 die Anthropic zelf publiceert, en 60 bij Artificial Analysis. Het meningsverschil gaat over de tegenstander, niet over Argon, en dat is een reden om de benchmark op uw eigen stack te draaien in plaats van een gat van andermans slide af te lezen.
Wat kost een realistische Nederlandse pilot werkelijk?
Hier is het rekenwerk met de aannames erbij, zodat u ze door uw eigen aannames kunt vervangen. Neem een documentworkload zoals een organisatie in deze omvangsklasse er daadwerkelijk een pilot mee draait: 2.000 documenten per maand van elk 8.000 input- en 1.500 outputtokens, dus 16 miljoen input- en 3 miljoen outputtokens.
- Op de standaardtier: $32 input plus $30 output, dus $62 per maand nu en $124 vanaf december.
- Op batch, want dat is wat deze workload in werkelijkheid is: $16 plus $15, dus $31 per maand nu en $62 vanaf december. Een documentrun die 's nachts draait heeft geen reden om als interactief te worden afgerekend.
Let op welke knop meer oplevert. Die workload naar de juiste tier verplaatsen levert evenveel op als de verhoging van december kost, en het blijft daarna opleveren. Teams die het standaardtarief opvoeren voor een batchbare klus betalen een latencypremie die ze niet gebruiken. De tierkeuze verdient meer aandacht dan de datum.
Verander de vorm en de verhoging komt harder aan. Een agentic workload die schrijft in plaats van leest, zeg 500 runs per maand van 20.000 input- en 8.000 outputtokens, is 10 miljoen input en 4 miljoen output: $20 plus $40, dus $60 nu en $120 vanaf december. Die is echt interactief, dus de batchtier is er niet voor beschikbaar, en output is waar de verdubbeling pijn doet.
Het zijn kleine bedragen, en dat zeggen is nuttiger dan ze dramatiseren. In een AI-project in het middensegment is de modelrekening zelden het begrotingsrisico; integratie, datawerk en de mensen die het draaien zijn dat wel. De reden om dit uit te rekenen is niet het totaal, maar dat een voorstel met een novembertarief in een begroting voor 2027 een terugkerende regel met de helft onderschat.
Waar staan de gegevens, en wiens plicht is het?
Dit is de vraag die uw security officer als eerste stelt en die de benchmarkberichtgeving nooit beantwoordt. Algemene beschikbaarheid via de Gemini API en Google AI Studio is niet hetzelfde als beschikbaarheid in een Europese regio, en een API-endpoint is geen residentiegarantie, dus zoek in de locatiedocumentatie van Google Cloud op uit welke regio's uw eigen project wordt bediend. Stel vóór de pilot vast waar de inferentie draait, en bewaar het antwoord bij het model.
Er is meteen een register bij te werken. Onder de AI-verordening draagt een algemeen model dat u via een API aanroept de plichten van de aanbieder, terwijl het systeem dat u erop bouwt de uwe als gebruiksverantwoordelijke draagt, en de AI-geletterdheidsplicht uit artikel 4 geldt sinds 2 februari 2025. De AI Act-risicochecker geeft u in een paar minuten aan of wat u bouwt in een klasse valt waar u iets mee moet.
In het long-decodeprotocol schuilt nog een gevolg voor de facturatie. De modeldocumentatie van Google beschrijft dat input, thinking en output één venster van 1.048.576 tokens delen, met een standaardlimiet van 65.536 tokens per antwoord; daarboven zijn background execution en een verhoogde limiet nodig, waarna het model genereert in hops van maximaal 64K tokens die de aanroeper weer aaneenrijgt. Thinking-tokens tellen binnen dat outputbudget en worden tegen het outputtarief afgerekend. Een long-decodeklus op de achtergrond rekent zijn eigen redeneerwerk dus af op $10 per miljoen nu en $20 vanaf december.
Wat wij in de begrotingsregel voor 2027 zouden zetten
- Dateer elke offerte. Elk Argon-bedrag in een voorstel of een leveranciersraming is een novembergetal tenzij er iets anders bij staat. Vraag welk tarief en welke tier zijn aangenomen.
- Kies de tier vóór het model. De helft van de workloads waarmee een middensegmentteam pilots draait is batchbaar en wordt afgerekend alsof dat niet zo is. Die beslissing kunt u vandaag nemen en hij overleeft de prijswijziging.
- Draai de evaluatie vóór 30 november. Zes weken interactieve toegang met korting is een reëel venster voor een eerlijke vergelijking op uw eigen data, en dat is de enige vergelijking die een discussie tussen agentic scores en indexscores beslecht. Per workload een model kiezen beschrijft de werkwijze.
- Houd de overstap open. Gelijke lijstprijzen vanaf 1 december halen het prijsargument weg om voor een van beide te kiezen, waardoor modelonafhankelijk blijven de minder kostbare positie wordt in plaats van de principiële.
Crux Digits bouwt en draait AI-systemen náást de ICT-partner of het interne IT-team dat u al heeft. Wij doen niet uw servicedesk, uw infrastructuur of uw leverancierscontracten. Waar wij van waarde zijn is juist deze afweging: welk model en welke tier voor welke workload, wat het datapad doet, en wat vervangen over een jaar zou kosten. Ons werk met middelgrote organisaties staat bij toegepaste AI voor het middensegment, en hoe een implementatie hier verloopt bij AI-implementatie in Nederland.
Laatst bijgewerkt: 21 oktober 2026. Prijzen op die datum geverifieerd tegen de eigen prijspagina's van Google en Anthropic.
Wij bouwen maatwerk-AI en LLM-systemen die in productie draaien: een klikbare MVP bij het tweede gesprek, vaste stappen, en de code is van u.
AI-ontwikkelbureau in Nederland →