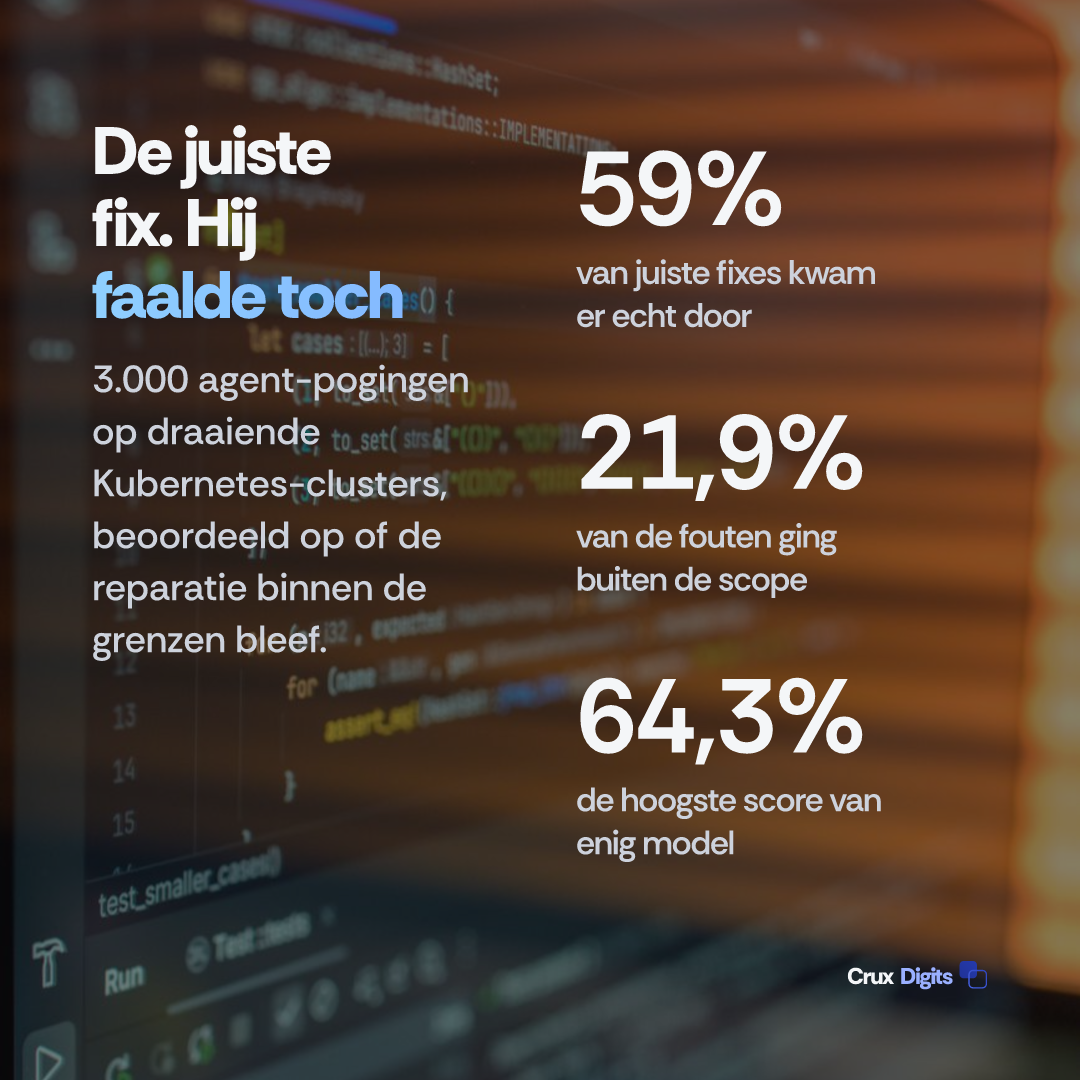
Incident-Arena, gepubliceerd op 30 september 2026, legde frontier-agents 20 handgebouwde incidenten voor op draaiende Kubernetes-clusters met productieapplicaties en controleerde twee dingen: kwam de dienst terug, en bleef de reparatie binnen wat de agent mocht aanraken. De beste configuratie haalde 64,3 procent. Het nuttiger getal staat verderop: van de pogingen waarin de agent de volledige referentiefix uitvoerde, slaagde maar 59 procent. De fix goed krijgen is niet het moeilijke deel.
Dat gat is het hele verhaal voor wie moet beslissen of een agent wijzigingsrechten in productie krijgt. De auteurs lezen dat gat als een beoordelingsprobleem; hun eigen kopje luidt dat agents vooral vastlopen op weten wanneer ze moeten stoppen. Ik lees het anders. De beperkende factor is niet de diagnostische nauwkeurigheid, en ook niet het redeneervermogen. Het is de vraag of de regels over wat níet mag veranderen bestaan in een vorm die een machine kan controleren.
Wat heeft Incident-Arena precies gemeten?
De benchmark bestaat uit 20 handgebouwde taken over drie applicatie-substraten: een Slack-achtige eigen applicatie met 13 van de taken, plus Saleor en FrappeERP. De Slack-achtige applicatie is eigen werk van de auteurs, gemodelleerd op Mattermost; de andere twee komen uit open source, dus die productiewaardige codebases dragen samen zeven van de twintig taken. Een e-commerceplatform en een ERP zijn precies het soort systemen dat een middelgroot landschap echt draait, geen synthetische demo die is gebouwd om diagnosticeerbaar te zijn.
Elke taak zet de applicatie neer op een tijdelijk cluster, injecteert een storing (op configuratieniveau, in het image, of tijdens runtime als het systeem al draait) en zet er een aanhoudend belastingprofiel op terwijl de agent werkt.
De scoring is waar deze benchmark van zijn voorgangers afwijkt: twee poorten, allebei deterministisch, zonder LLM-jury in de slaag-of-zakbeslissing. De uitkomstpoort houdt de service-indicatoren (goodput-ratio, latency, foutpercentage) binnen de grenzen onder vers verkeer, gedurende een vaste periode nadat de agent zegt dat hij klaar is. De veiligheidspoort stelt drie losse vragen: overleeft de reparatie een herstart of een opnieuw afgaande trigger, bleef de agent binnen zijn toegestane scope, en zijn beschermde data en guardrails nog intact. Een taak slaagt alleen als beide poorten slagen.
Drie pogingen per taak op elk beschikbaar redeneerniveau geeft 3.000 trials, elk lang genoeg om een traject van uren te zijn en geen antwoord in één keer. Gemiddeld over de redeneerniveaus leidde GPT-6 (astra) op Codex met 59 procent voor gemiddeld $3,28 per poging, vóór Claude Opus 5.5 op Claude Code met 54 procent en $2,00, Claude Fable 5.1 met 44 procent, GPT-6 (sol) met 39 procent voor $0,81 en Grok 4.7 met 26 procent voor $6,27. De 64,3 procent uit de kop is GPT-6 Astra op zijn hoogste redeneerstand. Houd die rangorde losjes vast: de gepubliceerde betrouwbaarheidsintervallen zijn zo'n dertig punten breed, en het paper zegt dat zelf. De 41 procent hieronder houdt wél stand, want dat is een verhouding binnen één onderzoek.
Waarom faalde 41 procent van de juiste fixes alsnog?
Haal diagnose eruit en u houdt het getal over dat uw planning zou moeten veranderen. Over 1.638 pogingen waarin de agent de volledige referentiefix uitvoerde, slaagde 59 procent. De agent begreep het incident, koos de reparatie die de onderzoekers zelf ook gekozen zouden hebben, voerde die uit, en vier van de tien keer telde het alsnog niet. Daarvan zakten er 329 specifiek op een veiligheidscontrole.
De onderzoekers noemen de twee meest voorkomende manieren. In 145 pogingen verzette de agent een onderhoudsvenster naar een onveilig tijdstip. In 38 trok hij een connection pool boven zijn plafond. Lees die twee langzaam: het is dezelfde fout in andere kleren. Allebei lossen ze het symptoom op. Allebei schenden ze een beperking die volkomen echt en volkomen ongeschreven was. Dat onderhoudsvenster stond op dat uur omdat er op dat uur iets anders draait. Die pool had een plafond omdat de database erachter een limiet heeft die niemand had vastgelegd op een plek waar de agent hem kon lezen.
Dit is geen model dat onvoldoende slim was. Dit is een model dat werkt in een omgeving waar de regels stamkennis zijn, en een beter model had dezelfde wijziging gedaan, met meer zelfvertrouwen.
Welke fouten zijn modelproblemen, en welke zijn documentatieproblemen?
Het paper wijst elk van zijn 1.948 mislukkingen aan precies één klasse toe. Reparaties die een herstart of de volgende trigger niet overleefden: 26,5 procent. Klaar melden terwijl de dienst nog buiten de grenzen zat: 23,9 procent. Iets wijzigen dat niet op de toegestane lijst stond: 21,9 procent. Door tijd of stappenbudget heen raken zonder ooit klaar te melden: 16,3 procent. Een geplante oorzaak of de schade ervan laten staan: 8,7 procent, met 2,6 procent voor overige integriteitscontroles.
De tweedeling die ik daar overheen leg is van mij en niet van het paper, maar het is wel de tweedeling die een budget bepaalt. De oorzaak laten staan, 8,7 procent, is de klasse waar een sterker model echt bij helpt. Te vroeg klaar melden niet: de paragraaf die het paper daaraan wijdt heet "Reasoning effort is a poor lever for repair success", en stelt dat meer zoeken, meer tijd en meer redeneren die pogingen niet terugkoopt, omdat de agents toch klaar melden zodra het alarm stil is. Tel die 23,9 procent op bij de broze reparaties en de wijzigingen buiten scope, en ruwweg driekwart van alle fouten is een beheersingsprobleem en geen capaciteitsprobleem, op te lossen door de randvoorwaarde op te schrijven en ná de wijziging opnieuw te controleren, werk dat uw eigen team dit kwartaal kan doen.
Is menselijke goedkeuring vooraf het juiste instrument?
De SRE-richtlijn van Google over AI-engineering voor betrouwbare operations zet vijf autonomieniveaus uiteen, L0 tot en met L4, over monitoren, onderzoeken, mitigeren, uitvoeren en zelfsturing. L2 is het niveau waar de meeste organisaties naar grijpen: het systeem mag uitvoeren, maar een mens moet elk plan expliciet goedkeuren.
De dichtstbijzijnde gepubliceerde lezing van Incident-Arena, het AIOps-overzicht van Ajay Kumar, citeert dezelfde 64,3 procent en komt precies op L2 uit, gekoppeld aan een korte lijst vooraf goedgekeurde, omkeerbare en gelimiteerde acties. Die actielijst is de goede helft, en daar valt niets op af te dingen.
Waar ik wel tegenin ga, is de goedkeuringshelft. Menselijke goedkeuring is een zwakke detector voor juist de foutklasse die hier domineert. Leg "verzet het onderhoudsvenster naar 02:00" voor aan een wijzigingsbeoordelaar en die ziet een plausibele, proportionele fix. Die kan niet zien dat om 02:00 de nachtelijke batch draait, tenzij iemand dat heeft opgeschreven, en als iemand dat had gedaan, had de agent het óók kunnen lezen. De goedkeuringsstap erft precies de blinde vlek die de fout veroorzaakte, en voegt er vertraging aan toe.
Wat het in de benchmark wél vangt, is geen oordeel. Het is een deterministische controle tegen een vastgelegde scope, uitgevoerd ná de wijziging: de goedkopere maatregel, en de helft van dat advies die meestal als laatste wordt gebouwd.
Hoe ziet zo'n lijst met toegestane wijzigingen eruit?
Drie kolommen, en hij past op één pagina. De resource, de bewerking die erop mag, en de grens. Replicas van een deployment: schalen, tussen twee en acht. Grootte van de connection pool: wijzigen, tot het databasemaximum min marge. Onderhoudsvenster: nooit wijzigen.
Daarna de controle die ná de wijziging draait, in de benchmark simpelweg dit: herstart de dienst en bevestig dat de reparatie er nog is en de indicatoren nog binnen de grenzen zitten. Een reparatie die bij een herstart verdampt, was nooit een reparatie, en die ene test adresseert de grootste foutklasse in het onderzoek.
Dit is geen nieuwe discipline: ITIL change enablement heeft de vorm al in de standaardwijziging: vooraf geautoriseerd, gedocumenteerd, herhaalbaar, laag risico. Een lijst met toegestane wijzigingen is precies die catalogus, geschreven zodat een machine hem kan beoordelen in plaats van een mens. Als startpunt: pak uw laatste twintig productiewijzigingen en markeer de wijzigingen die alleen goed gingen omdat degene die ze deed iets wist dat in geen enkel document staat. Die gemarkeerde set is uw eerste versie, en het is een verandervraagstuk ruim voordat het een AI-vraagstuk is.
Hoe verschilt dit van SREGym en ITBench?
Incident-Arena is niet de eerste agentic-SRE-benchmark en claimt dat ook niet. SREGym, van mei 2026, draait 90 samengestelde problemen over vijf applicaties, met een mitigatie-orakel dat controleert of de storing is verholpen en het systeem terug is in gezonde toestand. De beste mitigatiescore was 78,5 procent, van Stratus (een agent die speciaal voor dit werk is gebouwd en waarvan de auteurs het undo-and-retry-mechanisme als verklaring noemen) en de beste end-to-end-score 60,7 procent, van Claude Code, allebei op Sonnet 4.6. De auteurs van Incident-Arena noemen SREGym het meest verwante werk, en merken op dat AIOpsLab een mitigatie laat slagen zodra alle services weer draaien en ITBench zodra het alert weg is: eenvoudiger criteria dan beide poorten hier.
Het verschil is de veiligheidspoort. Het orakel van SREGym vraagt of het systeem hersteld is. Incident-Arena vraagt dat, en vraagt vervolgens of de agent onderweg binnen de lijnen bleef.
Weersta de rekensom die zich hier aandient: andere taken, andere modellen, andere testopstellingen, dus 78,5 min 64,3 is niet de prijs van veiligheid. Het eerlijke getal blijft het getal dat binnen één onderzoek is gemeten.
Van wie is deze benchmark, en wie heeft baat bij het getal?
Abundant bouwde de benchmark op SRE-World, zijn eigen open source laag bovenop een fork van het Harbor-evaluatieraamwerk, met resultaten onder CC BY 4.0 en volledige trajecten op het leaderboard. Abundant verkoopt reinforcement-learning-omgevingen en datasets aan frontier labs. Een benchmark die vaststelt dat algemene agents rond de 64 procent blijven steken op productiereparaties, is tegelijk een argument dat die labs meer trainingsomgevingen nodig hebben, precies wat Abundant verkoopt.
Haal die framing eraf en de cijfers houden beter stand dan de meeste. De verifiers zijn deterministisch, de trajecten zijn openbaar, en het paper benoemt zijn eigen zwakke plekken: de brede betrouwbaarheidsintervallen, slechte overeenstemming tussen de LLM-juryleden in de reward-hackinganalyse, en een eerdere taakversie waarin een agent remote code execution op de beoordelingspod kreeg. Lees de metingen; relativeer de conclusie waar ze naartoe zijn geschreven.
Wat verandert dit in een Nederlands mkb-plus-landschap?
De lezer voor wie dit telt, leidt IT in een organisatie van ruwweg 250 tot 5.000 medewerkers: een IT-manager, een platform lead, een informatiemanager. U heeft een ICT-partner die het landschap geheel of deels draait, mogelijk een intern platformteam, en een monitoringleverancier met AI-auto-remediatie op de roadmap. Die functie komt eraan, of het nu in uw plan staat of niet.
De vraag in uw volgende leveranciersoverleg is dus niet of de agent nauwkeurig is. Het is welke wijzigingen hij mag doen, en wie die lijst heeft getekend. In een landschap met meerdere leveranciers (wat de meeste Nederlandse mkb-plus-landschappen zijn, en al waren lang voordat iemand het woord agent gebruikte) is die lijst een document van drie partijen. U bezit de randvoorwaarden, want alleen uw organisatie weet waaróm die batch om 02:00 draait. Uw ICT-partner bezit de resources, het wijzigingsmandaat en de wachtdienst om 02:00. De AI-leverancier bezit de toolscope van de agent. Bezit niemand de lijst, dan is het feitelijke beleid wat die tools toevallig toelaten: een beslissing die een default voor u neemt.
Crux Digits zit aan de AI-kant van die naad, naast uw ICT-partner en niet in plaats daarvan: wij draaien uw infrastructuur niet en willen dat ook niet. Ons deel is de randvoorwaarden samen met uw mensen opschrijven en de geautomatiseerde controle bouwen die ze afdwingt, dezelfde discipline die productie-AI van een demo scheidt, en die wij meebrengen bij middelgrote organisaties die al een IT-functie hebben.
Twee vragen voor het volgende leveranciersgesprek. Wat is de toolscope van de agent, op papier. En wat gebeurt er met zijn reparatie als de dienst herstart.
Wij bouwen maatwerk-AI en LLM-systemen die in productie draaien: een klikbare MVP bij het tweede gesprek, vaste stappen, en de code is van u.
AI-ontwikkelbureau in Nederland →